<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="ko"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://jnu-econovation.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://jnu-econovation.github.io/" rel="alternate" type="text/html" hreflang="ko" /><updated>2026-08-31T01:37:54+09:00</updated><id>https://jnu-econovation.github.io/feed.xml</id><title type="html">ECONOVATION</title><subtitle>IT 개발동아리 에코노베이션입니다.</subtitle><author><name>JNU-econovation</name></author><entry><title type="html">[2026 SUMMER DEV] DX11 기반 커스텀 게임 엔진 ‘[CoreCraft]’, 1인분팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_1%EC%9D%B8%EB%B6%84.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] DX11 기반 커스텀 게임 엔진 ‘[CoreCraft]’, 1인분팀" /><published>2026-08-29T00:00:00+09:00</published><updated>2026-08-29T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_1%EC%9D%B8%EB%B6%84</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_1%EC%9D%B8%EB%B6%84.html"><![CDATA[<h2 id="summer-dev-dx11-----corecraft-1">[2026 SUMMER DEV] DX11 기반 커스텀 게임 엔진 ‘[CoreCraft]’, 1인분팀</h2>

<h3 id="section">프로젝트 소개</h3>

<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/335e878c-0c63-4395-9aad-83b7744c0d02/image.png" alt="" /></p>

<p>1인분팀은 DX11 기반 커스텀 게임 엔진을 개발하였습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/0b4ce719-45cb-4030-8363-168a00800fdc/image.png" alt="" /></p>

<p>1인분팀은 GAME 현규님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>현규 : 제가 이번에 프로젝트로 진행한 Core Craft는 DX11을 기반으로 직접 제작한 커스텀 게임 엔진 및 에디터입니다.</p>

<p>GameObject에 여러 Component를 조합하는 구조로 설계하여, 필요한 기능을 독립적으로 관리하고 재사용할 수 있도록 만들었습니다.</p>

<p>또한 Scene 편집과 Viewport 렌더링, Component 속성 확인 기능을 하나의 에디터에서 사용할 수 있도록 구현했습니다.</p>

<p>FBX 파일은 Assimp를 통해 엔진 전용 리소스 형식으로 미리 변환하여, 런타임에서 모델과 애니메이션 데이터를 더욱 빠르게 불러올 수 있도록 했습니다.</p>

<p>렌더링에는 Phong Shading을 적용해 주변광, 난반사, 정반사, 발광 효과를 표현하고 3D 오브젝트에 자연스러운 입체감을 더했습니다.</p>

<p>특히 노드 기반의 Blueprint 기능을 구현하여, 별도의 코드 작성 없이도 게임 오브젝트의 동작을 시각적으로 구성하고 실행할 수 있도록 만들었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>현규 : 게임 엔진을 직접 구현하기 위해 새롭게 공부해야 할 내용이 많아 어려움을 겪었습니다.</p>

<p>특히 렌더링 파이프라인의 각 단계가 어떤 방식으로 연결되는지 이해하는 데 오랜 시간이 걸렸습니다.</p>

<p>DX11의 여러 기능과 그래픽스 관련 개념을 함께 공부해야 해서 생각보다 학습량도 많았습니다.</p>

<p>문제가 발생했을 때 어느 단계에서 잘못된 것인지 찾는 과정 역시 쉽지 않았습니다.</p>

<p>그래도 하나씩 직접 구현하고 결과를 확인하면서 전체적인 동작 과정을 이해할 수 있었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>현규 : 프로젝트를 진행하기 전에는 게임 엔진을 주로 사용하는 입장에서만 바라봤습니다.</p>

<p>하지만 렌더링 파이프라인과 에셋 처리 과정을 직접 구현하면서 엔진의 내부 동작을 이해할 수 있게 되었습니다.</p>

<p>화면에 하나의 오브젝트가 출력되기까지 얼마나 많은 과정이 필요한지도 알게 되었습니다.</p>

<p>이번 경험을 통해 새로운 기술을 접했을 때 내부 구조와 동작 원리부터 살펴보는 습관도 생겼습니다.</p>

<p>이번에 합격한 크래프톤 정글 게임테크랩에서도 비슷한 과정을 진행하기 때문에, 이번 경험이 앞으로도 많은 도움이 될 것 같습니다</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>현규 : 요즘은 codex나 claude code로 구현이 쉬우니까 일단 도전해보고 많이 시도해보는 게 좋은 것 같습니다. 저도 최근에 게임이 아닌 공모전을 준비하면서 이틀만에 뚝딱 앱을 만들었는데, 그정도로 요즘 구현이 쉽습니다. 그래서 좋은 아이디어가 있다면 주저하지말고 시도하는 게 좋은 것 같아요.</p>

<p><br /></p>

<p><strong>Q. 프로젝트의 기술적인 도전 과제나 혁신적인 부분은 무엇이었나요?</strong></p>

<p>현규 : 완전히 새로운 기술을 개발한 것은 아니지만, 게임 엔진의 기반 기술을 직접 구현했다는 점에 의미가 있습니다.</p>

<p>DX11 렌더링 파이프라인을 구성하고 Phong Shading을 적용하면서 그래픽스의 기본 원리를 익혔습니다.</p>

<p>또한 FBX 데이터를 엔진 전용 형식으로 변환하고, 런타임에서 불러오는 에셋 파이프라인을 구현했습니다.</p>

<p>컴포넌트 기반 구조와 노드 기반 Blueprint도 직접 만들어 보면서 엔진의 전체적인 구조를 경험했습니다.</p>

<p>기존 기술을 단순히 사용하는 데 그치지 않고, 내부에서 어떻게 동작하는지 이해하고 구현한 것이 가장 큰 기술적 도전이었습니다.</p>

<p><br /></p>

<p>지금까지 DX11 기반 커스텀 게임 엔진 ‘CoreCraft’를 개발한 1인분팀이었습니다!</p>]]></content><author><name>HYEONGYU</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] DX11 기반 커스텀 게임 엔진 ‘[CoreCraft]’, 1인분팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스 ‘[Gamelink]’, 404 NOT FOUND팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_404_NOT_FOUND.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스 ‘[Gamelink]’, 404 NOT FOUND팀" /><published>2026-08-29T00:00:00+09:00</published><updated>2026-08-29T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_404_NOT_FOUND</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_404_NOT_FOUND.html"><![CDATA[<h2 id="summer-dev----------gamelink-404-not-found">[2026 SUMMER DEV] 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스 ‘[Gamelink]’, 404 NOT FOUND팀</h2>

<h3 id="section">프로젝트 소개</h3>

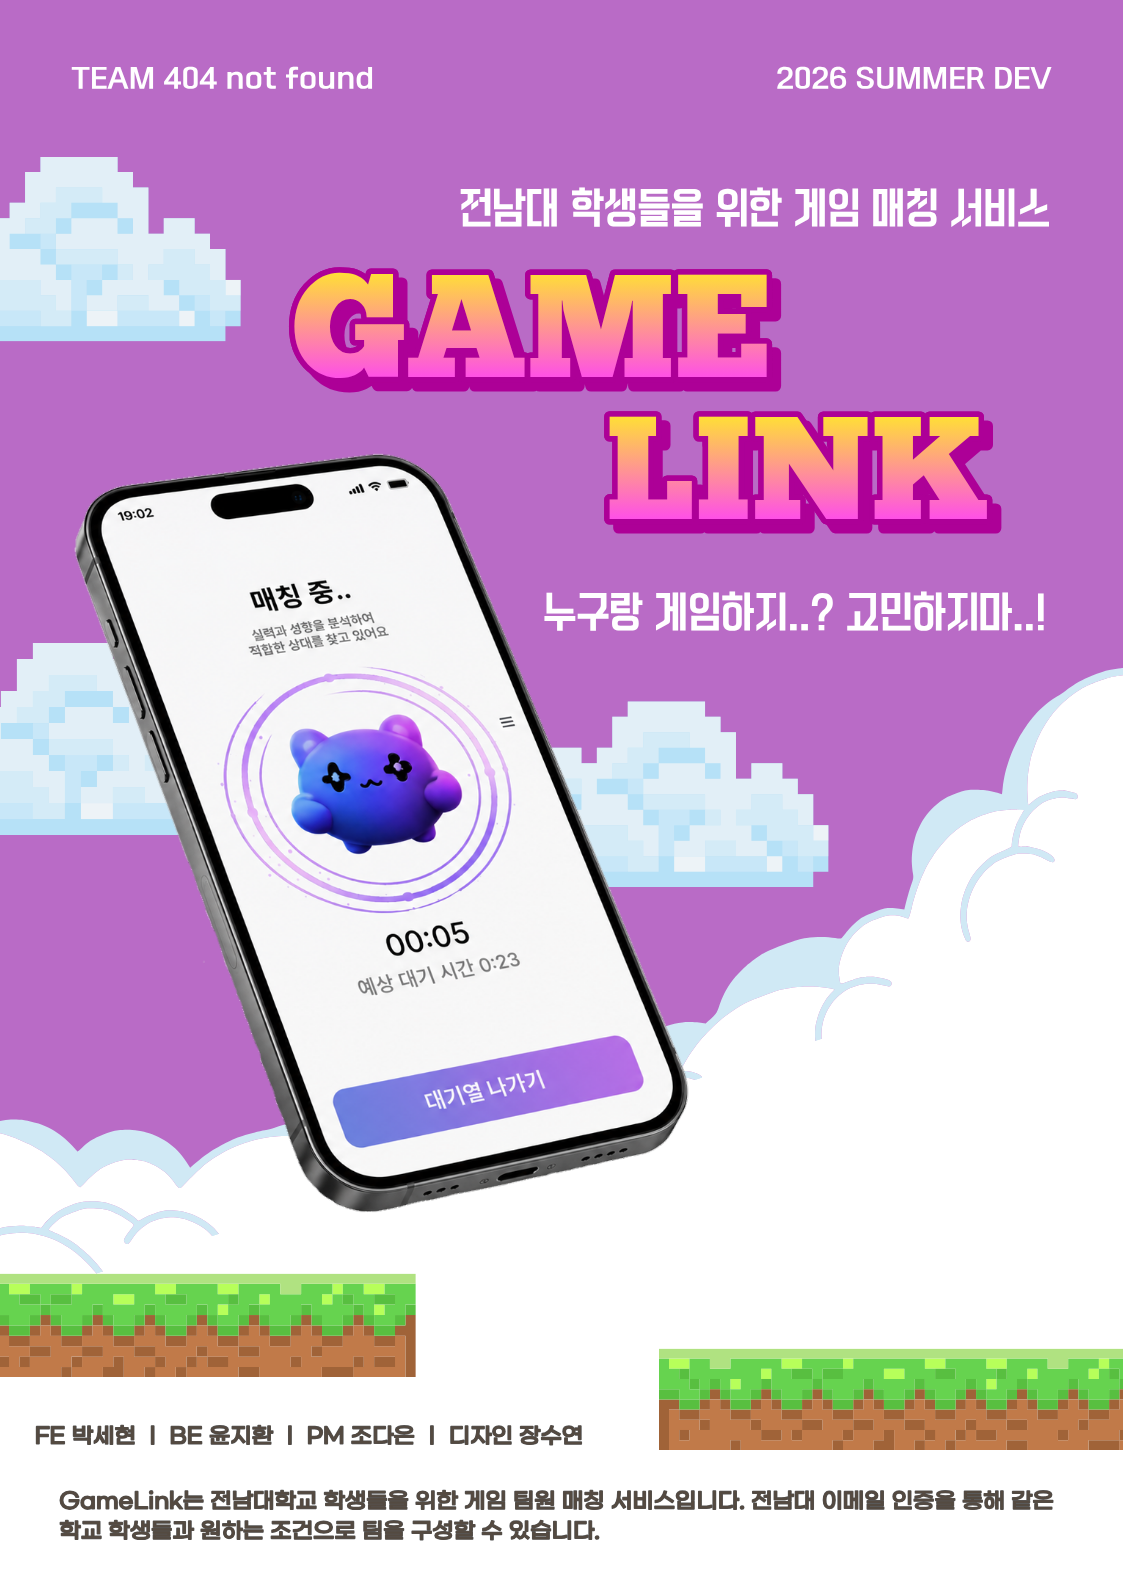
<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/cb6d77da-71a3-41fb-9c0f-a1586e7f6a56/image.png" alt="" /></p>

<p>404 NOT FOUND 팀은 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스인 Gamelink를 개발하였습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/fbd6fc69-87a2-4d1e-87ad-a93b31d0cfdb/image.png" alt="" /></p>

<p>404 NOT FOUND 팀은 FE 세현님, BE 지환님, PM 다은님, DE 수연님 으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>GameLink는 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스입니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>다은 : 팀원마다 생각하는 기능과 완성 모습이 같다고 생각했지만, 다른 점이 많았고, 꾸준히 소통하고 우선순위를 정해가며 해결했습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>세현 : 프로젝트 전보다 협업에서 소통과 역할 분담의 중요성을 이해하게 되었고, 아이디어를 실제 결과물로 구체화하는 경험을 얻었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>지환 : 처음부터 완벽하게 만들려고 하기보다 핵심 목표와 역할을 명확하게 정하고, 진행 상황을 자주 공유하는 것이 중요합니다.</p>

<p><br /></p>

<p><strong>Q. 기획자로서 프로젝트 초기에 어떤 역할을 수행하였고, 프로젝트 진행 중에 어떤 어려움을 겪었나요?</strong></p>

<p>다은 : 초기에 프로젝트를 다 같이 기획할때 의견나눈 내용을 바탕으로 앱화면 구조도를 작성해서 디자이너에게 전달하고 정책정의서를 정리해 개발자에게 전달했습니다.</p>

<p><br /></p>

<p><strong>Q. Summer Dev 프로젝트에서 개발자로 참여한 경험을 설명해 주세요. 어떤 역할을 맡았고, 주요 기술 스택은 어떻게 구성되었나요?</strong></p>

<p>세현 : 프론트엔드 개발을 담당해 로그인, 매칭, 마이페이지 등의 화면과 API 연결을 구현했습니다. React와 TypeScript를 중심으로 Vite, React Router, PWA 기술을 사용했으며, FastAPI 기반 백엔드와 연동했습니다.</p>

<p><br /></p>

<p><strong>Q. 디자이너로서 팀에 참여한 경험을 설명해 주세요</strong></p>

<p>수연 : 이번 프로젝트에서 디자이너로 참여해 앱의 전체적인 UI 디자인을 담당했습니다.</p>

<p>먼저 Miro를 활용해서 앱에 어떤 화면과 기능이 필요한지 정리하고 IA와 사용자 플로우를 구성했습니다. 이후 Figma를 이용해 회원가입, 홈 화면, 매칭 조건 설정, 매칭 중, 매칭 완료, 게임 완료, 마이페이지 등의 화면을 디자인했습니다.</p>

<p>특히 단순히 화면을 예쁘게 만드는 것보다 사용자가 게임을 선택하고 조건을 설정한 뒤 매칭되는 과정이 자연스럽게 이어지도록 화면 간 연결성을 중점적으로 생각했습니다.</p>

<p><br /></p>

<p><strong>Q. 개발자로서의 역량 향상을 위해 어떤 노력을 기울였으며, 이 프로젝트를 통해 어떤 기술적 성장을 이루었나요?</strong></p>

<p>지환 : 이전에는 주로 화면 구현에 집중했지만, 프로젝트를 통해 API 요청과 응답, 인증 토큰, 라우팅과 배포 구조까지 전체적인 서비스 흐름을 이해하게 되었습니다. 또한 문제의 원인을 직접 찾고 적절한 기술을 선택해 해결하는 능력을 키울 수 있었습니다.</p>

<p><br /></p>

<p>지금까지 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스 ‘Gamelink’를 개발한 404 NOT FOUND 팀이었습니다!</p>]]></content><author><name>HYEONGYU</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] 게임,티어,포지션 등의 조건을 기반으로한 전남대 학생들의 게임 매칭 서비스 ‘[Gamelink]’, 404 NOT FOUND팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] 그룹의 취향을 모아, 확실한 선택지를 주는 음식 추천 서비스 ‘[운식]’, 르네상스팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_%EB%A5%B4%EB%84%A4%EC%83%81%EC%8A%A4.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] 그룹의 취향을 모아, 확실한 선택지를 주는 음식 추천 서비스 ‘[운식]’, 르네상스팀" /><published>2026-08-29T00:00:00+09:00</published><updated>2026-08-29T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_%EB%A5%B4%EB%84%A4%EC%83%81%EC%8A%A4</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_%EB%A5%B4%EB%84%A4%EC%83%81%EC%8A%A4.html"><![CDATA[<h2 id="summer-dev-----------">[2026 SUMMER DEV] 그룹의 취향을 모아, 확실한 선택지를 주는 음식 추천 서비스 ‘[운식]’, 르네상스팀</h2>

<h3 id="section">프로젝트 소개</h3>

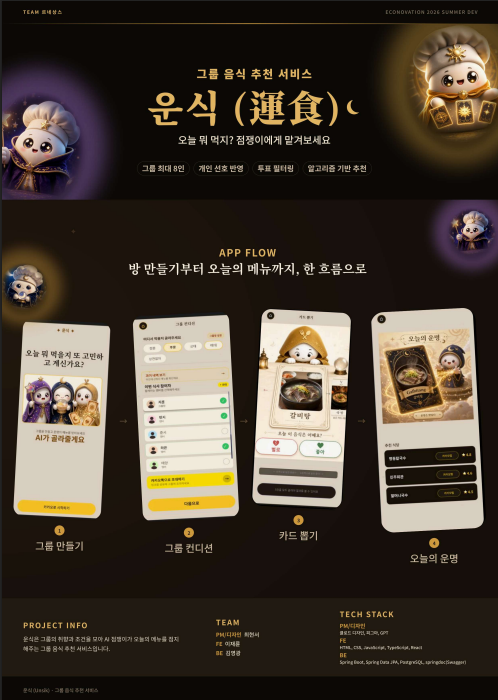
<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/cf4f3742-de1c-4807-a04f-670400016ba9/image.png" alt="" /></p>

<p>르네상스팀은 그룹의 취향을 모아, 확실한 선택지를 주는 음식 추천 서비스인 “운식”을 개발하였습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/114aaa94-098b-46cd-b106-4de5dd5e2bff/image.png" alt="" /></p>

<p>르네상스 팀은 BE 영광님, PM 현서님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>영광 : 운식은 그룹 안에서 뭐 먹을지를 대신 정해주는 그룹 메뉴 추천 서비스 입니다.</p>

<p>여러 명이 방에 모이면 각자 알레르기와 선호 카테고리를 입력하고 운명 카드를 뽑는 방으로 메뉴 추천받은 뒤 투표로 최종 그룹 메뉴 음식을 결정합니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>현서 : 이런 서비스의 핵심은 그룹원의 전원이 납득할 만한 메뉴가 나오는가였습니다. 그런데 음식 선택은 개인의 컨디션, 날씨, 선호도, 예산 등 수 많은 외부 요인이 얽혀 있습니다.</p>

<p>정확도를 높이려면 이걸 다 입력 받아야 하지만 그러면 서비스의 입력 과정의 흐름이 길어지기에 간편성이 떨어지는 문제가 발생했습니다. 결국 추천의 정확성과 사용 흐름의 간편성 사이에서 어느 지점을 잡을지가 어려운 문제였습니다. 그래서 1단계 목표는 만족스러운 메뉴를 맞히자가 아니라 한 명이라도 선호하지 않은 음식은 추천하지 말자라는 목표로 두고 개발하였습니다.</p>

<p>2단계는 데이터가 쌓인 뒤로 미뤘습니다. 사용 횟수가 늘면 개인의투표 기록과 그룹에서 최종 선정도니 메뉴 데이터가 쌓이므로 사용자에게 추가 입력을 하지 않고 추천 만족도를 올릴 수 있다고 판단했습니다.</p>

<p>간편성을 추구하면 많은 누적 데이터가 쌓이고 그 데이터를 활용해 그룹 메뉴 추천의 만족성을 높이는 방향으로 문제를 해결하였습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>현서 : 프로젝트 이전에는 피그마 툴, PM으로서의 역할에 대해 무지했었지만 한 번 경험을 해보니 관련 지식과 역할에 맞는 행동에 대해서 터득할 수 있었습니다. 또한, 협업이 굉장히 중요하고 그만큼 또 어렵다는 것도 깨닫게 되었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>영광 : 팀원들과 빠르게 친해지면 좋습니다! 팀원들과 의견 나누기 편해지고, 더 재밌게 프로젝트 과정을 진행할 수 있습니다 ㅎㅎ</p>

<p><br /></p>

<p><strong>Q. 기획자로서 프로젝트 초기에 어떤 역할을 수행하였고, 프로젝트 진행 중에 어떤 어려움을 겪었나요?</strong></p>

<p>현서 : 기획자로서 프로젝트 초기에 아이디어를 제시하고, 해당 아이디어가 어떤 문제를 해결할 수 있을지에 대해 문제를 정의하고, 좋은 성과를 낼 수 있을지 고민했습니다. 또한 목표에 맞는 프로젝트의 방향성을 세웠습니다.</p>

<p>프로젝트를 진행하면서 겪은 가장 큰 어려움은 프로젝트에 대한 책임감을 가지고 끝까지 완성하는 것이었습니다. 조금 더 나은 제품을 만들기 위해서 계속 노력하고, 신경써야 하는데 이러한 의욕이 끝까지 지속되지 못한 것 같아 아쉬움이 있습니다.</p>

<p>그리고 기존 팀원들의 이탈이 있어, 잠시 어려움이 있었습니다. 하지만 남은 팀원과 앞으로 해야할 과제를 확인하고 으쌰으쌰 목표를 되새기며 프로젝트를 마무리 할 수 있었습니다.</p>

<p><br /></p>

<p><strong>Q. Summer Dev 프로젝트에서 개발자로 참여한 경험을 설명해 주세요. 어떤 역할을 맡았고, 주요 기술 스택은 어떻게 구성되었나요?</strong></p>

<p>영광 : 기술 스택은 Spring Boot 기반에 JPA와 Querydsl로 데이터 계층을 구성했고 DB는 PostgresSQL를 사용했습니다. 배포는 Railway를 통해 배포하였습니다.</p>

<p>이번 프로젝트에서 신경 쓴건 추천 알고리즘입니다. 알레르기과 같은 사용자가 불호거나 먹지 못한 음식을 추천 후보에 두지 않기 위해 알고리즘 로직을 신경 쓰였습니다. 음식 추천 후보풀이 적을때는 완화되도록 2단계 필터링 구조로 설계하였습니다.</p>

<p>즉 조건을 다 걸었을 떄 추천 결과가 안 나오는 불사상사를 방지하는 것을 최우선 과제로 두었습니다. 음식의 정보는 8개 카테고리 7개의 알레르기 태그로 분류하고였고 총 166개의 메뉴데이터베이스를 직접 구축하였습니다.</p>

<p><br /></p>

<p>지금까지 그룹의 취향을 모아, 확실한 선택지를 주는 음식 추천 서비스 ‘운식’을 개발한 르네상스팀이었습니다!</p>]]></content><author><name>HYEONGYU</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] 그룹의 취향을 모아, 확실한 선택지를 주는 음식 추천 서비스 ‘[운식]’, 르네상스팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] 인증된 후기로 만드는 안전한 일자리 지도 ‘[전남대 클린알바맵]’, 조오타팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_%EC%A1%B0%EC%98%A4%ED%83%80.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] 인증된 후기로 만드는 안전한 일자리 지도 ‘[전남대 클린알바맵]’, 조오타팀" /><published>2026-08-29T00:00:00+09:00</published><updated>2026-08-29T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_%EC%A1%B0%EC%98%A4%ED%83%80</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/29/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_%EC%A1%B0%EC%98%A4%ED%83%80.html"><![CDATA[<h2 id="summer-dev---------">[2026 SUMMER DEV] 인증된 후기로 만드는 안전한 일자리 지도 ‘전남대 클린알바맵’, 조오타팀</h2>

<h3 id="section">프로젝트 소개</h3>

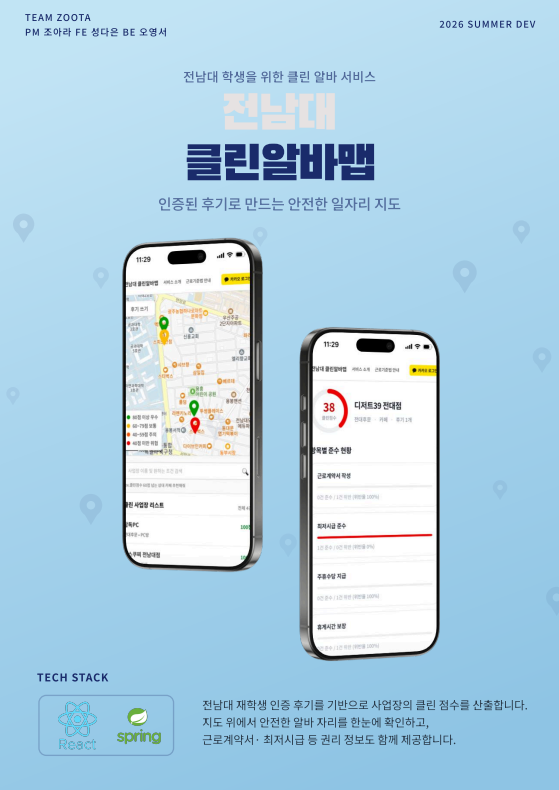
<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/1beb8ab1-a788-4129-bb52-f00c82259178/image.png" alt="" /></p>

<p>조오타팀은 인증된 후기로 만드는 안전한 일자리 지도, 전남대 학생들을 위한 클린 알바 서비스인 “전남대 클린알바맵”을 개발하였습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/hyeongyu4214/post/da3e26cb-a23a-4b3d-a288-8eadf7a797fd/image.png" alt="" /></p>

<p>조오타팀은 FE 다은님, BE 영서님, PM 아라님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>다은(FE) : 저희가 이번에 프로젝트를 진행 한 “전남대 클린알바맵”은 실제 근로를 인증한 대학생들의 생생한 후기를 바탕으로 투명하고 안전한 일자리 정보를 제공하는 지도 기반 웹 플랫폼입니다.</p>

<p>근로계약서 작성, 최저시급 준수 등 객관적인 지표를 평가하여, 각 사업장의 근로기준법 준수 여부를 지도 위 컬러 핀과 클린 지수로 직관적으로 시각화했습니다. 특히 리뷰 작성 시 발생할 수 있는 명예훼손 등 법적 리스크를 방지하고자, AI가 위험한 표현을 안전한 문장으로 자동 순화해 주는 스마트한 기능을 도입했습니다.</p>

<p>단순한 후기 공유를 넘어, 특히 20대 학생들이 놓치기 쉬운 아르바이트 전 필수로 알아야 할 근로 권리 정보와 대처 가이드를 함께 제공하여 실질적인 권리보호를 할 수 있도록 도와주는 기능도 함께 만들었습니다.</p>

<p>결과적으로 근로자와 선량한 사업주 모두가 상생할 수 있는 신뢰 기반의 생태계를 구축하고, 지역 사회 내 공정한 아르바이트 문화를 선도하는 것이 저희 프로젝트의 최종 목표입니다!</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>영서(BE) : 프로젝트 후반으로 갈수록 기능 하나를 추가하면 생각하지 못했던 곳에서 문제가 생기는 일이 많았습니다.</p>

<p>프론트엔드와 백엔드에서 시간을 처리하는 방식이 달라 방금 작성한 리뷰가 9시간 전으로 표시되기도 했고, 관리자 페이지에서는 리뷰 승인은 되는데 인증 자료가 보이지 않는 문제도 있었습니다. 로컬에서는 잘 되던 기능이 실제 서버에 올렸을 때 다르게 동작하는 경우도 있어서, 코드를 수정하는 것만으로 끝나는 일이 생각보다 많지 않았습니다.</p>

<p>가장 기억에 남는 건 후기 분위기를 긍정·중립·부정으로 나누는 기능을 추가했을 때입니다. 신규 리뷰에는 값이 잘 저장됐지만, 이미 DB에 있던 리뷰에는 해당 값이 없어서 기존 리뷰들이 통계에서 빠지는 문제가 생겼습니다.</p>

<p>결국 새 기능만 구현하는 것이 아니라 기존 데이터까지 보정하는 DB 마이그레이션을 추가하고, 이전 데이터와 새 데이터가 모두 정상적으로 반영되는지 다시 확인해야 했습니다. 이런 경험을 하면서 새 기능이 잘 동작하는 것뿐 아니라 기존 데이터나 프론트엔드, 배포 환경까지 같이 봐야 한다는 점이 가장 어려웠던 부분이었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>아라(PM) : 저희 팀이 프로젝트 전후로 가장 크게 달라진 점은 팀원들끼리 전보다 훨씬 친해졌다는 점입니다.</p>

<p>초반에는 서로 어색해서 아이디어나 의견을 낼 때 소극적은 분위기였는데요. 중간에 다 같이 소중단 SW 경진대회를 준비하면서 많이 친해진 것 같습니다. 대회 준비 중에 같이 고생하다보니 이전보다 가까워지고 팀워크도 끈끈해졌습니다.</p>

<p>이 이후로 프로젝트 회의하면서 서로 눈치 보지않고 피드백도 솔직하게 주고받을 수 있어서 훨씬 수월하고 즐겁게 마무리할 수 있었습니다. 그리고 개인적으로는 기획자로서의 역량이 이전보다 훨씬 성장하였습니다.</p>

<p>이전에는 팀원들에게 아이디어를 말로만 설명하려다 보니 많은 어려움이 있었는데요. 이번 프로젝트를 하면서 피그마로 직접 와이어프레임도 그려보고 디자이너를 대신하여 UI 디자인을 하면서 피그마를 다루는 능력도 이전 보다 많이 늘은 것 같습니다. 또 기능명세서를 작성하면서 개발자와 소통하는 법도 배웠습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>아라(PM) : 제가 꼭 전하고 싶은 팁은 Figma Make 활용법입니다. Figma Make를 사용할 때 팁을 하나 드리자면, 프롬프트를 구체적일수록 결과물도 좋아진다는 것입니다.</p>

<p>단순히 ‘이런 기능 만들어줘’라고 하면 결과물이 원하는 대로 잘 안나오고 많이 엇나가서 오히려 수정하는 데 시간이 더 걸리더라고요. 그래서 프롬프트를 작성하실 때, UI 에 쓰일 컬러 팔레트나 원하는 폰트, 참고할 레퍼런스를 최대한 구체적으로 첨부하는 것을 추천합니다.</p>

<p>AI 에게 조건과 가이드를 확실하게 잡아줄수록 원하는 디자인을 훨씬 수월하게 얻어내실 수 있을겁니다.</p>

<p><br /></p>

<p><strong>Q. 기획자로서 프로젝트 초기에 어떤 역할을 수행하였고, 프로젝트 진행 중에 어떤 어려움을
겪었나요?</strong></p>

<p>아라(PM) : 프로젝트 초기에는 전남대 알바맵의 타겟인 대학생들이 알바를 구하며 실제로 어떤 불편함을 겪는지 분석하는 데 집중했습니다.</p>

<p>단순히 팀원들끼리의 추측으로 기획하기보다는 확실한 근거가 필요하다고 생각해서, 설문조사를 기획하고 주변 대학생들의 의견과 데이터를 수집했습니다. 이렇게 분석한 설문 결과를 바탕으로 저희 서비스에 꼭 필요한 핵심 기능들의 우선순위를 정하고 서비스의 전반적인 방향을 잡는 역할을 하였습니다.</p>

<p>가장 어려웠던 점은 개발자분들과의 소통이었습니다. 기획자의 의도를 정확하게 전달하는 것이 생각보다 훨씬 까다롭다는 것을 깨달았습니다. 처음에는 스케치나 말로만 설명하면 될 줄 알았는데, 본격적인 개발에 들어가니 생각하지 못했던 예외 상황이 정말 많았습니다.</p>

<p>이 부분을 해결하기 위해 디테일한 기능명세서를 작성하기 시작했습니다. 문서를 기준으로 대화하다보니 소통하면서 발생하는 오해가 전보다 줄어들었고, 개발자분들과 어떻게 의견을 맞추고 소통해야 하는지 실무적 능력을 배울 수 있었습니다.</p>

<p><br /></p>

<p><strong>Q. Summer Dev 프로젝트에서 개발자로 참여한 경험을 설명해 주세요. 어떤 역할을 맡았
고, 주요 기술 스택은 어떻게 구성되었나요?</strong></p>

<p>다은(FE) : 저는 이번 프로젝트에서 프론트엔드 개발을 맡아 React를 기반으로 프로젝트 전반의 UI/UX 설계 및 핵심 화면 구현을 담당했습니다.</p>

<p>핵심 기술 스택으로는 React를 활용해 컴포넌트를 설계했으며, Zustand와 Axios로 상태 관리 및 서버 API와의 안정적인 통신 환경을 구축했습니다. 사용자 접근성을 높이기 위해 카카오 로컬 API 연동 지도를 메인으로 구축하고, 모달 형태의 서비스 소개 팝업창과 유용한 정보를 담은 근로기준법 안내 페이지를 개발했습니다.</p>

<p>특히 AI 순화 기능이 적용된 후기 쓰기 페이지와, 사업장별 항목 준수 현황을 긍정 지표(%)로 직관적으로 시각화한 후기 자세히 보기 페이지를 사용자 친화적으로 구현했습니다. 또한 플랫폼 운영 효율을 높이기 위해 데이터베이스와 연동된 후기 검수용 ‘관리자 페이지’까지 독립적으로 구축하며 프론트엔드의 전체적인 흐름을 완성했습니다.</p>

<p>그리고 최종적으로 Vercel을 이용해 프로젝트를 배포하였습니다. 이번에 처음 프론트엔드를 맡아서 개발을 해보면서 어려움 점도 많았지만 하나의 프로젝트를 직접 만드는 과정에서 많은 것들을 배울 수 있어서 좋은 경험이 되었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트의 기술적인 도전 과제나 혁신적인 부분은 무엇이었나요?</strong></p>

<p>영서(BE): 이번 프로젝트에서는 생성형 AI를 단순히 API로 연결하는 데서 끝내지 않고, 서비스 안에서 어떤 역할까지 맡길지 정하는 것을 많이 고민했습니다.</p>

<p>저희는 Upstage의 Solar Pro 2를 활용해 후기 순화와 자연어 검색 기능을 구현했는데, 하나의 프롬프트로 여러 작업을 처리하기보다는 후기 순화와 검색 조건 추출처럼 목적이 다른 기능을 각각 나누어 구성했습니다.</p>

<p>Spring Boot에서는 RestClient 를 이용해 Solar API를 호출했고, 기능마다 별도의 시스템 프롬프트와 응답 형식을 사용했습니다.특히 자연어 검색에서는 AI가 직접 검색 결과를 만들어 주도록 하지 않았습니다. 실제로 존재하지 않는 사업장을 추천하거나 사용자가 입력하지 않은 조건을 임의로 만들어낼 가능성이 있다고 생각했기 때문입니다.</p>

<p>그래서 Solar는 사용자의 자연어를 지역, 업종, 점수 등의 검색 조건이 담긴 JSON 형태로 변환하는 역할만 담당하고, 실제 검색은 백엔드에서 해당 조건을 받아 JPA와 MySQL을 통해 처리하도록 했습니다. 후기 순화 기능에서도 AI가 후기를 완전히 새로 작성하는 대신 욕설이나 인격적인 표현, 법적으로 단정적인 표현 등을 확인하고, 원래 의미를 최대한 유지한 순화 문장 후보를 제시하도록 했습니다.</p>

<p>최종 문장은 사용자가 직접 선택할 수 있도록 구성했습니다. 처음에는 생성형 AI를 서비스에 붙이는 것 자체가 가장 어려울 것이라고 생각했는데, 실제로 구현해 보니 AI에게 무엇을 시킬지보다 어디까지 시키지 않을지를 정하는 것이 더 중요하다는 점을 느꼈습니다.</p>

<p>AI가 자연어를 이해하고 정리하는 부분을 담당하고, 정확한 데이터가 필요한 부분은 기존 백엔드와 DB가 담당하도록 역할을 나눈 것이 이번 프로젝트에서 가장 의미 있었던 기술적 시도였습니다.</p>

<p><br /></p>

<p>지금까지 대학생을 위한 투명하고 안전한 일자리 지도 ‘전남대 클린알바맵’을 개발한 조오타팀이었습니다!</p>]]></content><author><name>HYEONGYU</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] 인증된 후기로 만드는 안전한 일자리 지도 ‘전남대 클린알바맵’, 조오타팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] 서울시 열섬 완화를 위한 AI 기반 녹지 분석 프로젝트 ‘SEOULution’, ECOLUTION팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_ECOLUTION.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] 서울시 열섬 완화를 위한 AI 기반 녹지 분석 프로젝트 ‘SEOULution’, ECOLUTION팀" /><published>2026-08-27T00:00:00+09:00</published><updated>2026-08-27T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_ECOLUTION</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_ECOLUTION.html"><![CDATA[<h2 id="summer-dev-----ai-----seoulution-ecolution">[2026 SUMMER DEV] 서울시 열섬 완화를 위한 AI 기반 녹지 분석 프로젝트 ‘SEOULution’, ECOLUTION팀</h2>

<h3 id="section">프로젝트 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/3d02a93f-79dd-41d8-b835-f61afb27603b/image.png" alt="1" /></p>

<p>ECOLUTION팀은 서울시 열섬현상을 해결하기 위해, 필요한 녹지 면적을 AI를 활용해 분석한 “SEOULution” 프로젝트를 진행했습니다!</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/5851517a-f14f-4df9-964d-27d5f6a0f5b1/image.png" alt="ecolution" /></p>

<p>ECOLUTION팀은 AI 은교님, AI 준서님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>은교 : 서울루션(설루션)은 도시 열섬현상 (도시에서 열이 갇혀 빠져나오지 못하고, 더위를 가중화하는 현상)을 하나의 문제점으로 잡고, 녹지가 열섬현상을 완화시킬 수 있는지 확인하고 목표 온도 달성을 위해 녹지가 얼마나 필요한지 분석하는 프로젝트 입니다.</p>

<p>국내에서 열섬현상이 가장 심한 서울시를 배경으로 하며 다양한 공공데이터와 통계적 방법을 사용해서 프로젝트를 완성했습니다.</p>

<ul>
  <li><strong>Statistical Verification (통계적 검증):</strong> 상관분석을 진행하여 지표면 온도와 식생 지수의 상관관계를 분석하여 녹지의 열섬 완화 효과를 검증하였습니다.</li>
  <li><strong>Target Area Selection (우선 구역 선정):</strong> 자치구 별로 사회·환경 변수를 ‘녹지 필요도’에 따라 Natural Breaks 기법을 통해 1~7 단계로 분할 후 종합적으로 고려하여 녹지 분석을 진행할 구역을 선정하였습니다.</li>
  <li><strong>Deep Learning Quantification (딥러닝 기반 면적 계산):</strong>  U-Net, DeepLabV3+, SegFormer 모델을 사용하여 선정 구역 내 녹지인 픽셀을 분할하고, 해상도를 기준으로 현재 녹지 면적을 계산하였습니다. (U-Net mIoU = 0.8725)</li>
  <li><strong>Regression-based Estimation (회귀 기반 녹지 면적 추정):</strong> 지형 조건 변수를 기반으로 GWR 회귀식을 구축하여 목표 지표면 온도 달성 시 얼만큼의 녹지 면적이 필요한지 계산하였습니다. (R² = 0.84)</li>
</ul>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>준서 : 처음 AI를 접하다 보니 인공지능이 잘하는 일은 무엇이고 못하는 일은 무엇인지 정확히 알지 못하는 상황이었습니다. 이는 프로젝트의 주제를 선정하는 과정에서 가장 큰 어려움이 되었지만, 팀원과 멘토분들간의 적극적인 소통으로 이를 해결했습니다.</p>

<p>첫번째로 겪은 문제는 방대한 데이터 용량과 촬영 범위의 한계였습니다.</p>

<p>저희는 서울의 항공 사진에서 녹지가 얼마나 있는지를 분석해 서울시의 전체 녹지 면적을 계산하고자 했습니다. 하지만 항공 사진은 높은 해상도로 데이터 용량의 부족 문제가 있었습니다. 또한 동일한 시간대를 기준으로 서울시 전체에 해당하는 항공 사진이 없었습니다. 이를 해결하기 위해 먼저 계획을 변경했습니다. 해상도는 더 낮지만 위의 문제들을 해결 가능한 위성 사진을 이용해 대략적으로 서울시에서 녹지가 부족한 자치구를 선정한 후에 해당 자치구의 항공 사진을 통해 녹지 면적을 계산하는 방식으로 문제를 해결했습니다.</p>

<p>두번째로는 항공 사진의 위치 데이터 부재였습니다.</p>

<p>자치구의 항공 사진으로 녹지 면적을 분석하기 위해 다운 받은 항공 사진에는 위치 데이터 정보가 없었고, 그 결과로 용산구에는 지표면 온도, 불투수 면적, 폭염일 수, NDVI(정규 식생 지수) 등의 데이터들까지 모두 반영되지 않는 문제가 발생했습니다.</p>

<p>이때는 이 문제를 어떻게 해결할지 정말 막막해서 두손 두발 다 들고 있었는데요. 그러던 중 Github에서 저와 같은 문제로 골머리를 겪은 개발자분이 올려주신 해결 방안이 있었습니다. 항공 사진에는 위치 정보를 암시하는 코드가 있는데 이를 위치 데이터로 자동으로 변환하는 코드 덕분에 문제를 해결할 수 있게 되었고 다시 한번 정보 공유의 가치와 네트워크의 중요성을 깨닫게 되었습니다.</p>

<p>세번째로는 데이터간의 가중치 기준의 모호성이였습니다.</p>

<p>저희는 서울시 자치구를 대상으로 지표면 온도가 1도 떨어진다고 가정 했을 때 얼마정도의 녹지면적이 필요한지 추정하고자 했습니다. 이를 위해 지표면 온도에 영향을 주는 1.농경지/초지면적 2.산림/가로수 면적 3.불투수면적 4.수계와의 거리 5. 지형 고도 데이터를 수집했습니다.</p>

<p>하지만 어떤 요인이 지표면 온도에 어느정도의 가중치를 주는지 모르기 때문에 다중선형회귀분석과 GWR(공간데이터분석)을 진행해야 했습니다. 분석시에는 많은 표본이 필요하기에 서울시 전체를 약 5000개 정도의 동일한 격자로 자르고 각 격자에 앞서 말한 5가지의 데이터를 넣어 분석을 진행하여 데이터 간의 가중치를 설정하게 되었습니다.</p>

<p>이러한 과정을 통해 이론으로만 배웠던 다중선형회귀분석을 실제로 적용해본 점과 일반적인 데이터가 아닌 공간 데이터이기에 그에 맞는 분석(GWR)을 연계하여 문제를 해결해본 경험이 이번 프로젝트에서 가장 많이 배우고 공부했던 내용이었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>준서 : 사실 AI를 개발하거나 만들어내는 역량은 아직도 많이 부족하다고 생각합니다. 그렇지만 이번 프로젝트를 진행하면서 컴퓨터 비전 분야를 공부하게 되었는데 AI가 이미지를 입력하고 출력하는 방법과 그 흐름을 알게 되었습니다.</p>

<p>또한 항공 사진의 무거운 데이터와 공공 데이터의 서로 다른 형태로 존재하는 데이터들을 하나의 기준을 가지고 결과를 도출해내는 과정을 통해 어떤 방식으로 진행해야 프로젝트가 원활히 진행되는지 어느 정도 감을 잡게 된 것 같습니다!</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>은교 : 데이터/AI 프로젝트를 기획부터 시작하는 게 처음이었기 때문에 주제를 선정하는 데 굉장히 어려움을 많이 겪었던 것 같습니다. 사실 아직도 AI 공부를 어떻게 하는지 잘 모릅니다… 하지만 제가 생각하는 좋은 방법은 일단 하고 싶은 연구나 프로젝트를 먼저 생각하고,  그 다음에 어떻게 구현할 수 있을지 생각해 보는 게 괜찮은 방법이라는 생각이 듭니다.</p>

<p>레퍼런스도 찾아보고, LLM한테 질문도 해 보고, 어떤 식으로 프로젝트 방향이 흘러가야 하는지 계속 점검하다 보면 어느 순간 꽤 괜찮은 프로젝트로 완성이 되어 있더라고요. 제가 생각했을 때 이제는 LLM을 쓰냐 안 쓰냐가 실력의 차이를 가르는 게 아니라, 본인이 기획한 프로젝트를 얼마나 설명할 수 있는지 + 실제로 구현할 수 있는지가 진짜 실력을 만들 수 있다고 생각합니다.</p>

<p>그렇기 때문에 어떤 사람이라도 어떤 분야든 간에 도전하기가 정말 쉬워진 것 같다는 생각이 들어요. 원하는 프로젝트가 있다면 기획 틀을 먼저 잡고 어떤 방법론으로 만들 수 있을지 고민하며 프로젝트를 완성해 나가시는 걸 추천드립니다. 화이팅!!</p>

<p><br /></p>

<p><strong>Q. Summer Dev 프로젝트에서 개발자로 참여한 경험을 설명해 주세요. 어떤 역할을 맡았고, 주요 기술 스택은 어떻게 구성되었나요?</strong></p>

<p>은교 : 이번 프로젝트에서는 논리 연결을 위해 데이터를 수집하는 과정이 많아서 다양한 공공데이터를 수집하고 가공해서 프로젝트를 완성시켰습니다. 위성 데이터를 활용해보고 싶었는데 GEE를 사용해서 간단하게 데이터를 저장하고 학습에 사용할 수 있었습니다.</p>

<p>또한 pytorch 기반으로 U-Net, DeeplabV3+, SegFormer 같은 모델 학습을 진행하였고 각 모델의 결과를 비교하는 과정을 거쳤습니다. (엘리스랩의 GPU 지원이 있었기 때문에 단기간에 이러한 결과물을 뽑아낼 수 있었습니다. ㅠㅠ)</p>

<p>회귀분석을 할 때 모든 변수가 독립적이라는 가정 하에 진행을 해야 하는데 지리공간 상의 데이터이기 때문에 실제로 그 가정이 성립할 수 없었습니다.</p>

<p>따라서 GWR(Geographically Weighted Regression)방법으로 사용했고 OLS로 진행했을 때보다 독립성, 설명력 측면에서 개선하는 것에 성공했습니다.</p>

<p><br /></p>

<p><strong>Q. 본인 팀만의 특별한 협업 방식이 있나요? 있다면 소개해 주세요.</strong></p>

<p>준서 : 저희 팀은 노션과 슬랙을 주 협업 도구로 사용했습니다! 프로젝트를 하면서 진행했던 팀 회의와 자신이 맡은 파트에서의 작업물을 노션을 통해 공유하고 기록하였습니다.</p>

<p>또한 프로젝트의 초안과 개요, 필요한 공공데이터와 논문 조사 , 모델 관련  페이지도 각각 나누어서 저장해 나중에라도 필요한 정보는 바로바로 볼 수 있게 정리했습니다. 저희는 슬랙을 통해 주로 의견을 주고 받았는데 서로 조금이라도 궁금하거나 공유할 자료가 있다면 바로바로 연락을 하기로 약속했습니다!</p>

<p>소통 또한 프로젝트에서 중요한 부분이라고 생각해서 최대한 연락은 빠르게 보고 서로 피드백이 필요한 부분은 서슴없이 말하면서 의견을 적극적이고 협조적으로 조율해가면서 프로젝트를 진행했습니다!</p>

<p><br /></p>

<p>지금까지 서울시 열섬 완화를 위한 AI 기반 녹지 분석 프로젝트 “SEOULution”을 진행한 ECOLUTION팀이었습니다!</p>]]></content><author><name>sanghyeon</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] 서울시 열섬 완화를 위한 AI 기반 녹지 분석 프로젝트 ‘SEOULution’, ECOLUTION팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] 동아리의 모든 서비스를 한 곳에서 보는 플랫폼 ‘ECO-KNOCK’, Keyring팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_Keyring.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] 동아리의 모든 서비스를 한 곳에서 보는 플랫폼 ‘ECO-KNOCK’, Keyring팀" /><published>2026-08-27T00:00:00+09:00</published><updated>2026-08-27T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_Keyring</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_Keyring.html"><![CDATA[<h2 id="summer-dev--------eco-knock-keyring">[2026 SUMMER DEV] 동아리의 모든 서비스를 한 곳에서 보는 플랫폼 ‘ECO-KNOCK’, Keyring팀</h2>

<h3 id="section">프로젝트 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/abb0b1ee-fbda-4904-8790-93997363ba40/image.png" alt="1" />
<img src="https://velog.velcdn.com/images/sanghyeon1225/post/569a44bf-d943-432d-ab4a-8eac59b6092f/image.png" alt="2" /></p>

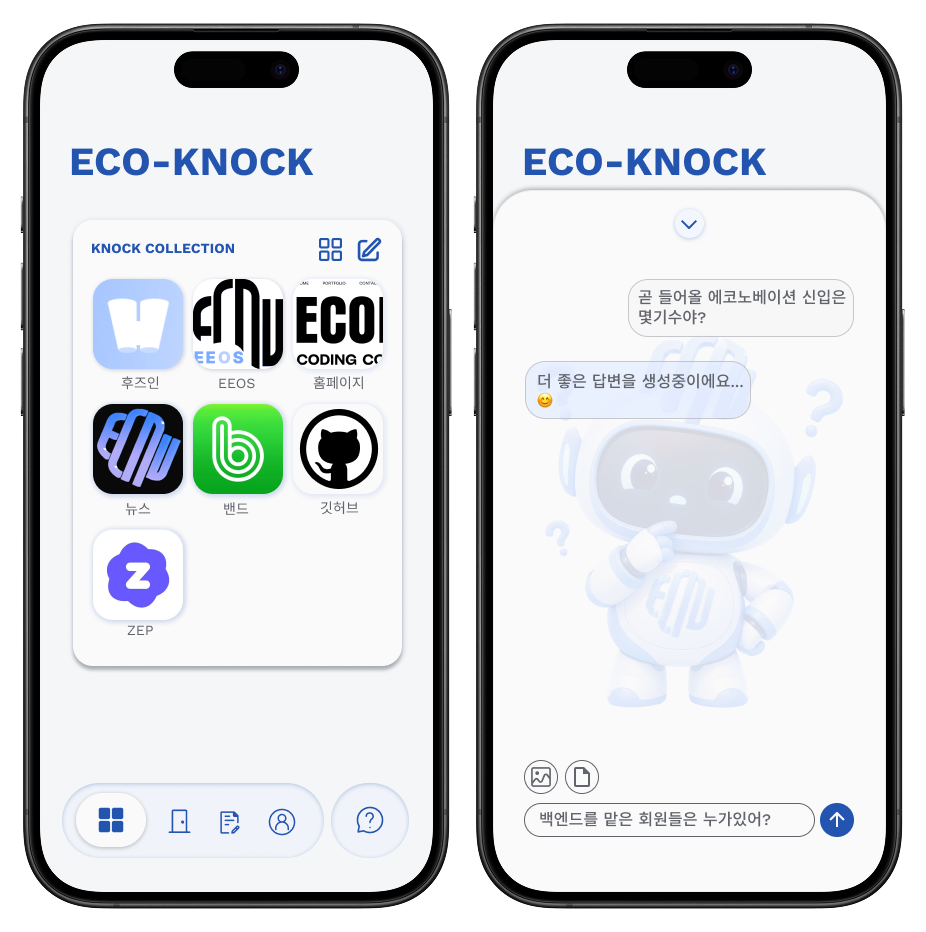
<p>Keyring팀은 에코노베이션의 모든 서비스와 부서 지원, 동아리방 정보를 한번에 확인할 수 있는 플랫폼 “ECO_KNOCK”을 개발했습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/9935b938-8971-4071-9fb7-77e4c36188bd/image.png" alt="keyring" /></p>

<p>Keyring팀은 FE/BE 선주님, PM 봄님, BE 수랑님, BE 준희님, AI 해서님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>수랑 : ECO-KNOCK은 흩어져 있던 동아리 프로젝트나 자주 쓰는 링크를 한 곳에 모아, 신입도 쉽게 동아리 활동을 시작할 수 있도록 돕는 종합 플랫폼입니다. 프로젝트를 둘러보고, 동방의 공기질을 실시간으로 확인하며, 관심 있는 부서에 지원까지 할 수 있습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>봄 : 처음에는 동방 문을 내부에서 열어주는 장치를 직접 설계하고 초인종 기능도 만들어 보자는 쪽으로 기획을 했었습니다. 하지만 현실적으로 보안 관련하여 한계를 느꼈고, 기획을 조금 변경하여 동아리 모든 링크를 모아주는 프로젝트로 변경했습니다. 결과적으로는 동아리의 모든 것을 한 눈에 확인 할 수 있게 되어 더 좋았던 것 같습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>준희 : 프로젝트 시작 전에는 블록체인의 기본 개념과 스마트 컨트랙트의 역할은 알고 있었지만, 이를 실제 서비스의 백엔드 및 사용자 계정과 연결해 본 경험은 없었습니다.</p>

<p>이번 프로젝트를 통해 스마트 컨트랙트 구현과 배포 뿐만 아니라 사용자별 지갑 생성, 온체인 잔액 조회, 사용자 데이터 암호화, 보상 정산 및 지급까지 하나의 흐름으로 연결하는 경험을 할 수 있었습니다.
특히, 블록체인 위에서 동작하는 컨트랙트만 잘 작성한다고 해서 전부가 아니라는 것을 체감하였습니다.</p>

<p>트랜잭션의 비동기성, 토큰 중복 지급 방지, 가스비를 지불하는 운영 지갑 관리 등 중앙 서버와 운영 환경에서 함께 고려해야 할 요소가 많았습니다. 이를 통해서 개별 기능의 구현보다 전체 데이터 흐름과 예외 상황을 먼저 생각하고 설계하는 습관을 가져야 된다는 생각을 하게 되었습니다.</p>

<p>또한, 이전에는 블록체인 서비스를 프로젝트에 도입할 경우, 사용자에게 별도의 지갑 생성과 등록 과정을 요구해야 하며, 이 과정은 서비스의 진입 장벽이 높이는 문제라고 생각했습니다.</p>

<p>이번 프로젝트에서는 중앙 서버가 사용자별 지갑을 자동으로 생성하고 관리하는 방식을 직접 설계하고 구현함으로써, 사용자가 블록체인이나 지갑에 대한 사전 지식이 없어도 온체인 서비스를 이용할 수 있도록 설계하였습니다. 이 경험을 통해 향후 다른 프로젝트에 블록체인을 도입할 때에도 지갑 사용으로 인해 발생하는 진입 장벽을 고려하여 사용자 편의성과 보안을 모두 충족하는 구조를 보다 수월하게 설계할 수 있게 되었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>해서 : 프로젝트를 처음 시작할 때는 막막하기도 하고, ‘내가 할 수 있을까?’ 하는 불안이 생길 수도 있습니다.</p>

<p>하지만 처음부터 현실적인 제약이나 구현 가능성만 생각하기보다는, 우선 팀원들과 정말 해보고 싶은 주제가 무엇인지를 자유롭게 찾아보았으면 좋겠습니다. 하고 싶은 주제를 찾고난 뒤, 기획 단계에서 구현하고 싶은 기능들을 정리하고 우선순위를 정해 MVP부터 차근차근 만들어가는 방식으로 진행하면, 주어진 시간과 팀원 개개인의 역량에 맞춰 자연스럽게 프로젝트의 범위를 설정할 수 있는 것 같습니다.</p>

<p>구현 과정에서는 AI를 적극적으로 활용하는 것도 좋은 방법이라고 생각합니다. 다만 AI가 제시하는 답을 그대로 받아들이기보다는, ‘왜 이렇게 구현되는지’, ‘더 나은 방법은 없는지’를 스스로 계속 생각하고 고민해보는 과정도 함께 가져갔으면 좋겠습니다.</p>

<p>문제가 생겼을 때도 AI를 활용해 다양한 해결 방법을 찾아볼 수 있지만, AI와 함께 고민해도 해결되지 않는 부분은 혼자 붙잡고 있기보다 팀원들과 공유해보는 건 어떨까요? 저는 팀원들과 이야기를 나누는 과정에서 새로운 해결책을 찾는 경우가 많았습니다.
마지막으로, 데브까지 우리에게 주어진 시간은 약 4~5개월입니다. 처음부터 모든 것을 완벽하게 해내려고 하기보다는, 목표를 세우고 하나씩 꾸준히 만들어가다 보면 분명 좋은 결과물을 완성할 수 있을 것입니다. 팀원들과 함께 차근차근 프로젝트를 만들어가셨으면 좋겠습니다!</p>

<p><br /></p>

<p><strong>Q. 사용자 경험(UX) 및 사용자 인터페이스(UI) 디자인에 대한 고려 사항이 어떠했나요? 사용자들의 피드백을 어떻게 수용하였나요?</strong></p>

<p>봄 : 우리가 만들고 있는 어플 버튼 하나하나의 쓰임을 생각해보면서, 시중에 나와있는 어플들 중 가장 비슷하다고 생각되는 어플 UX/UI를 참고하려고 노력했습니다. 예를 들면 부서 모집 페이지는 “열품타” 스터디그룹 가입 페이지를 참조했습니다. 최대한 깔끔하고 난잡해보이지 않으며 가독성(?)이 좋게 보이게끔, 많은 색을 사용하지 않고 글자 크기를 통일하는 등의 신경을 썼던 것 같습니다.</p>

<p>제가 디자인을 하면 팀원들이 디자인을 살펴주시면서 더 다양한 의견을 수용할 수 있었습니다. 그리고 사용자들의 피드백을 확인하기 위해 한 어플에서도 UX/UI가 업데이트 되어 어떻게 바뀌었는지 등을 찾아보려고 노력했습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트의 기술적인 도전 과제나 혁신적인 부분은 무엇이었나요?</strong></p>

<p>준희 : 가장 큰 기술적 도전은 블록체인에 익숙하지 않은 사용자도 별도의 노력 없이 온체인 토큰을 받을 수 있도록 만드는 것이었습니다. 일반적으로 블록체인 서비스를 이용하려면 사용자가 직접 지갑을 생성하고 서비스에 등록해야 하지만, 이러한 과정은 일반 사용자에게 높은 진입 장벽이 될 수 있다고 판단했습니다.</p>

<p>이를 해결하기 위해 회원이 처음 가입하면 중앙 서버가 사용자별 EVM 지갑을 자동으로 생성하고 각각의 회원 정보와 매핑하는 방식을 적용했습니다. 생성된 지갑의 개인키는 AES-256-GCM 방식으로 암호화하여 일반적인 데이터베이스에 저장함으로써 사용자 편의성과 보안을 함께 고려했습니다.</p>

<p>보상 지급 과정에서는 블록체인 트랜잭션의 비동기적인 특성과 중복 지급 가능성을 해결해야 했습니다. 서버가 트랜잭션을 전송하더라도 즉시 성공 여부를 알 수 없으며, 장애나 재시도로 같은 요청이 반복되면 보상이 중복으로 지급될 가능성이 존재했습니다. 이를 방지하기 위해, 날짜별 정산 요청마다 고유한 식별자인 batchId를 부여했습니다.</p>

<p>예를 들어, 2026년 1월 1일의 보상 요청에는 daily-reward:2026-01-01과 같은 문자열을 해싱한 값을 batchId로 사용합니다. 스마트 컨트랙트는 processedBatches라는 저장 공간에 각 batchId의 처리 여부를 true 또는 false로 기록합니다. 동일한 날짜의 지급 요청이 다시 전달되더라도 processedBatches[batchId]가 이미 true라면 해당 요청을 즉시 중단하게 됩니다.</p>

<p>반대로, 아직 처리되지 않은 요청이라면 보상을 지급하고 처리 상태를 true로 변경합니다. 또한, 지급 도중 오류가 발생한다면 트랜잭션 전체가 취소되어 처리 상태 변경과 토큰 전송이 모두 원상 복구됩니다. 이를 통해 서버에서 동일한 트랜잭션을 재시도하더라도 실제 보상은 단 한 번만 지급되도록 설계하였습니다.
보상 지급 과정에서는 블록체인 트랜잭션의 비동기적인 특성과 중복 지급 가능성을 해결해야 했습니다.</p>

<p>서버가 트랜잭션을 전송하더라도 즉시 성공 여부를 알 수 없으며, 장애나 재시도로 같은 요청이 반복되면 보상이 중복으로 지급될 가능성이 존재했습니다. 이를 방지하기 위해, 날짜별 정산 요청마다 고유한 식별자인 batchId를 부여했습니다. 예를 들어, 2026년 1월 1일의 보상 요청에는 daily-reward:2026-01-01과 같은 문자열을 해싱한 값을 batchId로 사용합니다. 스마트 컨트랙트는 processedBatches라는 저장 공간에 각 batchId의 처리 여부를 true 또는 false로 기록합니다.</p>

<p>동일한 날짜의 지급 요청이 다시 전달되더라도 processedBatches[batchId]가 이미 true라면 해당 요청을 즉시 중단하게 됩니다. 반대로, 아직 처리되지 않은 요청이라면 보상을 지급하고 처리 상태를 true로 변경합니다. 또한, 지급 도중 오류가 발생한다면 트랜잭션 전체가 취소되어 처리 상태 변경과 토큰 전송이 모두 원상 복구됩니다. 이를 통해 서버에서 동일한 트랜잭션을 재시도하더라도 실제 보상은 단 한 번만 지급되도록 설계하였습니다.</p>

<p>추가로, 중앙 서버에는 트랜잭션 해시와 처리 상태를 저장하여 지급 과정을 추적할 수 있도록 하였으며, 트랜잭션이 온체인에서 확정된 이후에만 사용자의 지급 이력을 생성하도록 설계하였습니다.</p>

<p>WhozIn에서 제공하는 재실 데이터를 실제 온체인 보상으로 연결하는 과정 역시도 주요 도전 과제였습니다.</p>

<p>WhozIn 측에서 제공하는 API를 통해 회원별 재실 시간을 가져오고, 이를 중앙 서버의 회원 및 지갑 정보와 연결한 뒤, 출석 보상과 시간별 보상으로 계산해야 했습니다. 이후, 계산 결과를 여러 사용자의 지갑 주소와 지급량으로 변환하여 RewardDistributor 스마트 컨트랙트에 일괄 전달하도록 구현하였습니다. 이를 통해, 재실 기록 조회부터 보상 계산, KRT 지급, 트랜잭션 확정 및 지급 이력 저장까지 하나의 흐름을 구축할 수 있었습니다.</p>

<p>이번 프로젝트를 통해 서버 관리형 지갑, 개인키 암호화, 중복 지급 방지 및 트랜잭션 상태 추적을 함께 구현하면서 블록체인 기능을 실제 서비스에서 운영하기 위해 필요한 요소들을 경험할 수 있었습니다.</p>

<p><br /></p>

<p><strong>Q. 개발자로서의 역량 향상을 위해 어떤 노력을 기울였으며, 이 프로젝트를 통해 어떤 기술적 성장을 이루었나요?</strong></p>

<p>수랑 : 개발할 때는 기능을 구현하는 것에 그치지 않고, “이 방식이 데이터가 늘어난 뒤에도 괜찮을까?”를 한 번 더 확인하는 습관을 기르려고 노력했습니다.</p>

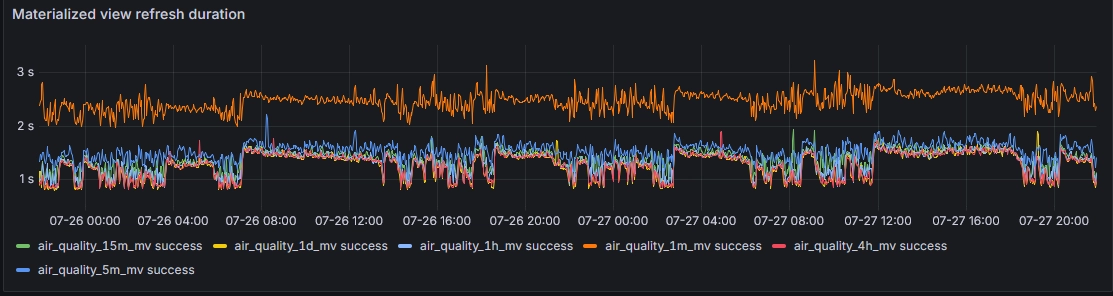
<p>이 프로젝트에서는 동방 공기질 데이터를 약 1초마다 수집합니다. 처음에는 데이터를 그대로 조회해도 문제가 없었지만, 시간이 쌓이면 하루나 한 달 단위의 기록을 확인할 때 데이터베이스에 부담이 될 수 있다고 생각했습니다. 그래서 원본 데이터는 저장하면서도, 조회할 때는 시간 단위로 미리 정리된 데이터를 활용하도록 구성했습니다.</p>

<p>또한 단순히 적용하는 데서 끝내지 않고, 원본 데이터를 직접 조회하는 방식과 비교해 보고, 실제로 데이터가 안정적으로 갱신되는지도 지속적으로 확인했습니다. 아래처럼 시간 단위별 데이터 갱신 시간을 모니터링하면서, 조회를 빠르게 만드는 방식이 운영 환경에 과도한 부담을 주지 않는지도 함께 살폈습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/39efda9f-907a-4ba2-9c3d-f8dd14399344/image.png" alt="중간1" /></p>

<p>이 경험을 통해 기능 구현 전부터 데이터 규모와 사용 상황을 함께 고려하는 관점을 배웠습니다. 앞으로도 “동작하는 기능”을 넘어, 오래 안정적으로 사용할 수 있는 기능을 만드는 개발자가 되고 싶습니다.</p>

<p><br /></p>

<p><strong>Q. 문제에 대한 개선 방향은 어떤 것이 있을까요?</strong></p>

<p>해서 : 저는 팀 프로젝트에서 에코노베이션 동아리 챗봇을 개발하는 역할을 맡았습니다. 동아리 관련 문서를 수집해 RAG 구조를 구축하고 Gemini API에 연결하여, 사용자 질문이 들어오면 문서 검색이 필요한지를 판단한 뒤 필요한 경우 RAG를 통해, 그렇지 않은 경우 Gemini의 일반 답변으로 응답을 생성하도록 했습니다.</p>

<p>개발 과정에서 동아리원 설문 결과를 바탕으로 한 질문들과 기본적인 질문들로 테스트를 반복하며 예상치 못한 문제들을 발견했고, 이를 하나씩 해결해나갔습니다. 데이터 수집, 검색 품질, 프롬프트 등 여러 레이어에서 문제가 나타났는데, 그 중 프롬프트 설계 개선 과정을 공유해보겠습니다</p>

<p>초기에는 단순하게 설계한 단일 프롬프트를 사용했습니다. 팀원들의 피드백을 통해 이 방식이 일관된 답변을 보장하지 못한다는 문제를 인식했고, 프롬프트 고도화의 필요성을 깨달았습니다.</p>

<p>사용자 질문을 분석해보니 세 가지 경우로 나눌 수 있었습니다. 문서가 필요하고 관련 문서가 있는 경우, 문서가 필요하지만 관련 문서가 없는 경우, 문서가 필요하지 않은 일반 대화인 경우입니다. 각 경우에 맞는 프롬프트를 별도로 설계해 적용했습니다.</p>

<p>개선의 핵심 목표는 답변의 일관성 확보였습니다. 수정 사항을 적용할 때마다 정확도와 일관성을 함께 검증했고, 기준에 미치지 못하면 다시 수정하는 과정을 반복했습니다. 주요 적용 사항으로는 프롬프트를 세 가지로 분리, 벡터 유사도 점수(score)를 활용한 “모르는 것”의 기준 일관화, system_instruction으로 지시 강도 조절, 각 경우에 따른 temperature 차등 적용, 경계 케이스에 대한 예시(few-shot) 추가 등이 있습니다.</p>

<p>이 경험을 통해 문제를 발견했을 때, 세밀한 테스트로 원인을 특정하고, 해결 방법을 조사한 뒤, 하나씩 적용하며 검증해나가는 일련의 문제 해결 프로세스를 체득할 수 있었습니다.</p>

<p><br /></p>

<p>지금까지 동아리 서비스를 한 눈에 볼 수 있는 통합 플랫폼 “ECO-KNOCK”을 제작한 Keyring팀이었습니다!</p>]]></content><author><name>sanghyeon</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] 동아리의 모든 서비스를 한 곳에서 보는 플랫폼 ‘ECO-KNOCK’, Keyring팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] 제주도 게스트하우스 통합 플랫폼 ‘게하르방’, NoBrains팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_Nobrains.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] 제주도 게스트하우스 통합 플랫폼 ‘게하르방’, NoBrains팀" /><published>2026-08-27T00:00:00+09:00</published><updated>2026-08-27T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_Nobrains</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_Nobrains.html"><![CDATA[<h2 id="summer-dev------nobrains">[2026 SUMMER DEV] 제주도 게스트하우스 통합 플랫폼 ‘게하르방’, NoBrains팀</h2>

<h3 id="section">프로젝트 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/873f8968-714a-4f59-be68-de5f90a87c8e/image.png" alt="1" /></p>

<p>NoBrains팀은 제주 게스트하우스 큐레이션 서비스인 “게하르방”을 개발했습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/51c443c2-63e7-4c74-b5b5-8ad4547287d6/image.png" alt="nobrains" /></p>

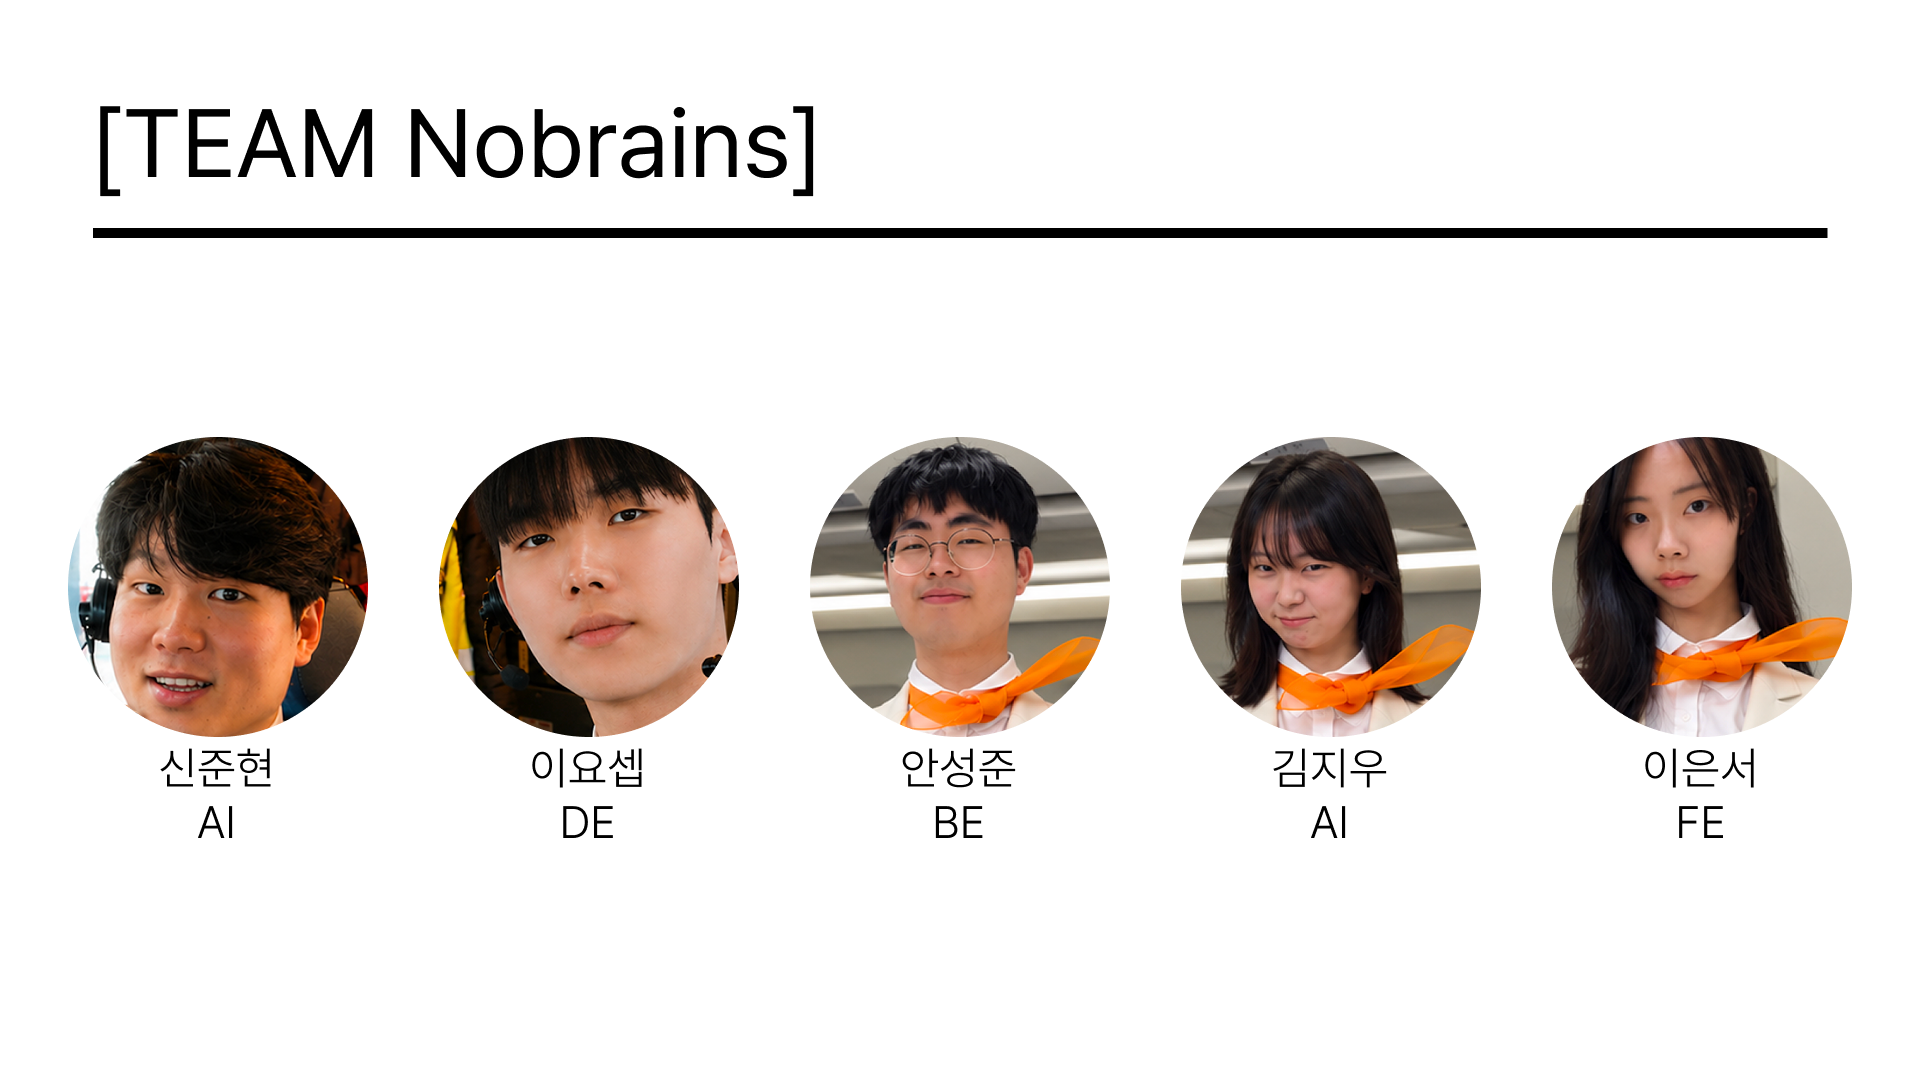
<p>NoBrains팀은 DE 요셉님, BE 성준님, FE 은서님, AI 준현님, AI 지우님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>성준 : 안녕하세요 저희는 제주 게스트하우스 큐레이션 서비스를 개발하고 있는 NoBrains 팀으로 디자인에 이요셉, 프론트엔드에 이은서, 백엔드에 안성준, AI 분야의 신준현와 김지우로 총 5명의 팀원으로 구성되어 있습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/1c622eb2-7af3-4622-b9a7-3fe8c8195d1e/image.png" alt="2" /></p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/f6662064-1108-45b8-b134-c5a7ef833c24/image.png" alt="3" /></p>

<p>저희 게하르방 서비스는 제주 게스트하우스를 한곳에서 탐색하고, 자신의 여행 취향에 맞는 게스트하우스를 찾을 수 있도록 돕는 제주 게스트하우스 큐레이션 플랫폼으로 지난 학기에는 게스트하우스 정보 제공과 스텝 구인·지원 등 서비스의 기본 기능을 구현하였습니다.</p>

<p>이번 학기에는 기존 서비스를 이어서 발전시키며 “사용자가 자신에게 잘 맞는 게스트하우스를 어떻게 더 쉽고 빠르게 찾을 수 있을까?”에 집중했습니다.</p>

<p>그래서 지도로 지역별 숙소 탐색을 할 수 있게 추가 기능을 개발하였고, 게스트하우스의 분위기와 특징을 쉽게 확인할 수 있도록 다양한 카테고리 정보를 개선하였습니다.</p>

<p>또한 리뷰 데이터를 활용해 숙소의 주요 특징을 파악하고, 사용자가 원하는 조건과 분위기를 입력하면 적합한 게스트하우스를 추천받을 수 있도록 AI 기반 추천 및 리뷰 분석 기능도 함께 고도화했습니다. 
이외에도 여러 채팅기능이나 알람기능, 여러 UI 개선등의 작업도 진행하였습니다 :)</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>준현 : 프로젝트를 시작할 때 제가 백엔드 경험이 부족했기 때문에 백엔드 공부를 하면서 백엔드 개발을 맡으려고 했습니다. 하지만 프로젝트를 진행하면서 백엔드를 공부하는 데 생각보다 많은 시간이 필요했고, 프로젝트에서 제가 어떤 역할을 맡아야 하는지도 애매했던 것 같습니다.</p>

<p>그래서 성준, 지우, 저 이렇게 세 명이 따로 시간을 내서 현재 상황과 각자가 하고 싶은 역할에 대해 이야기했습니다. 그 과정에서 저는 백엔드보다는 AI를 활용해 기능을 구축하는 것에 더 관심이 있다는 것을 명확하게 이야기했고, 팀원들과 의견을 조율한 뒤 백엔드에서 AI 개발로 역할을 변경했습니다. 이후에는 RAG 개발에 집중하면서 프로젝트를 진행했습니다.</p>

<p>이 경험을 통해 가장 크게 느낀 것은 내가 어떤 일을 하고 싶은지 명확하게 판단하고, 그것을 팀원들에게 적극적으로 전달하는 것이 중요하다는 점입니다. 만약 당시 팀원들과 직접 이야기하지 않고 애매한 상태로 계속 진행했다면, 백엔드와 AI 어느 쪽에도 제대로 집중하지 못했을 것이라고 생각합니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>지우 : 이전 프로젝트와 비교했을 때 가장 크게 달라진 점은 서비스의 기능과 완성도뿐만 아니라 프로젝트를 바라보는 범위가 넓어졌다는 점입니다. 이번 프로젝트는 지난 프로젝트에 이어 ‘게하르방 v2’로 진행하였으며, 기존 서비스를 바탕으로 전반적인 디자인을 새롭게 구성하고 기능을 추가했습니다.</p>

<p>대표적으로 채팅 기능, AI 기능, 지도 기능이 새롭게 추가되었고, 사용자 경험을 고려한 리디자인도 함께 진행하면서 v1보다 한층 발전된 서비스를 만들 수 있었습니다.</p>

<p>팀적인 부분에서도 변화가 있었습니다. 새로운 팀원들과 프로젝트를 진행하면서 처음에는 서로 맞춰가는 과정이 필요했지만, 개발뿐만 아니라 친목 활동도 함께하면서 자연스럽게 가까워질 수 있었습니다. 그 결과 이전보다 의견을 편하게 주고받을 수 있게 되었고, 팀원 간의 소통과 협업 방식도 더욱 좋아졌다는 점이 달라진 부분이라고 생각합니다.</p>

<p>또한 이전에는 서비스를 개발하고 완성하는 것에 집중했다면, 이번에는 실제 사용자를 유입시키는 과정까지 경험했다는 점도 큰 변화였습니다. 게하르방 v2를 인스타그램을 통해 홍보하면서 어떤 콘텐츠가 사람들의 관심을 끌 수 있는지, 실제 사용자를 확보하기 위해서는 어떤 방식으로 서비스를 알리는 것이 효과적인지 고민하게 되었습니다. 이를 통해 개발과 디자인뿐만 아니라 홍보와 마케팅의 중요성까지 경험하며 서비스 전체를 바라보는 시야가 넓어졌습니다.</p>

<p><br /></p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/1a257798-4c2d-4461-a059-612a86577da5/image.png" alt="4" /></p>

<p>결과적으로 이번 프로젝트를 통해 단순히 기능을 개발하는 것에서 나아가 사용자 경험, 팀워크, 홍보와 마케팅까지 함께 고민하게 되었다는 점이 이전 프로젝트와 비교했을 때 가장 크게 달라진 점이라고 생각합니다!</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>은서: 프로젝트 경험이 여러 번 있는 팀이라면, 단순히 개발을 완료하는 것에 그치지 않고 추후 실제 사용자가 서비스를 이용하는 것까지 고려하여 프로젝트를 기획해 보는 것을 추천합니다. 실제 사용자를 생각하며 개발하다 보면 자연스럽게 사용자의 입장에서 기능과 화면을 고민하게 되고, 더욱 편리하고 사용하기 좋은 앱이나 웹을 만들 수 있습니다.</p>

<p>또한 서비스를 직접 사용자에게 제공하고 피드백을 받는 과정을 통해 개발할 때는 미처 발견하지 못했던 문제점이나 개선할 부분을 알 수 있습니다. 이러한 경험을 반복하면서 문제를 해결하는 능력을 기르고, 개발자로서 한 단계 더 성장할 수 있다고 생각합니다.</p>

<p>최근에는 AI를 활용하여 개발하는 경우가 많아지고 있기 때문에 개발 실력뿐만 아니라 어떤 서비스를 만들 것인지 결정하고 프로젝트의 방향을 설정하는 기획 능력도 중요해지고 있다고 생각합니다. 따라서 프로젝트를 시작할 때 어떤 문제를 해결하고 싶은지, 누구를 위한 서비스를 만들 것인지 등을 충분히 고민하여 방향성을 잡는 것이 중요합니다.</p>

<p>반대로 개발 프로젝트가 처음인 팀이라면 완성도 높은 결과물을 만드는 것에 너무 큰 부담을 갖기보다는, 내가 어떤 기술을 사용해 보고 싶은지, 프로젝트를 통해 어떤 역량을 키우고 싶은지를 먼저 생각해 보는 것을 추천합니다. 아직 다양한 개발 기술을 경험해 보지 않은 단계이기 때문에 여러 기술을 직접 사용해 보고 시행착오를 겪는 과정 자체가 좋은 경험이 될 수 있습니다. 처음부터 완벽한 프로젝트를 만들려고 하기보다는 새로운 기술에 도전하고, 직접 부딪히며 배우는 것을 목표로 프로젝트를 진행한다면 이후의 개발에도 큰 도움이 될 것이라고 생각합니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 개발 중 어려움을 겪은 경험이 있나요? 어떻게 해결했으며, 그 과정에서 얻은 교훈은 무엇인가요</strong></p>

<p>준현 : 프로젝트에서 RAG 기반 게스트하우스 추천 시스템을 개발하면서, RAG를 구축하는 것 자체보다 사용자의 질문에 맞는 게스트하우스를 정확하게 추천하는 과정에서 어려움을 겪었습니다.</p>

<p>처음에는 사용자의 질문을 그대로 임베딩하여 유사한 게스트하우스 정보를 검색하는 방식으로 구현했습니다. 예를 들어 “혼자 여행 가도 어색하지 않은 게하 추천해줘”, “자연 속에서 조용히 힐링하기 좋은 숙소 추천해줘”와 같은 질문은 적절한 결과를 가져왔습니다. 하지만 “1박 3만원 이하인 게하 추천해줘”처럼 가격과 같이 명확한 조건이 포함된 질문에서는 조건과 맞지 않는 숙소가 추천되는 문제가 발생했습니다.</p>

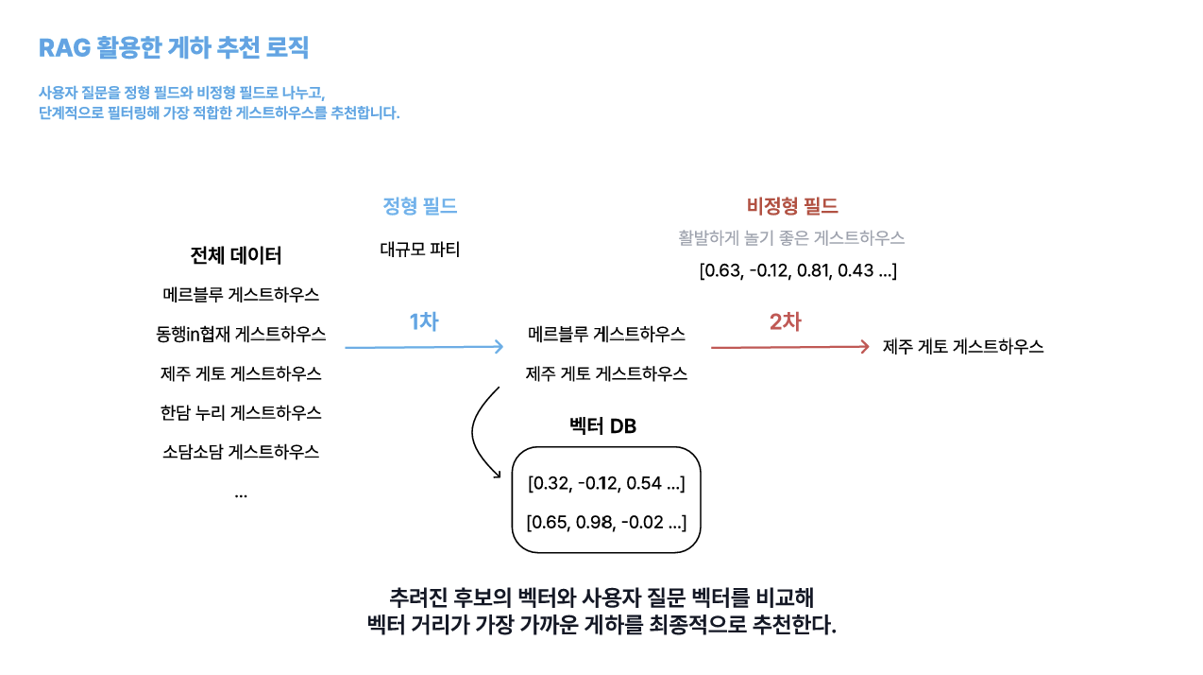
<p>이 문제를 해결하기 위해 RAG가 왜 해당 답변을 생성했는지를 분석할 필요가 있다는 강의를 본 기억이 떠올랐습니다. 그래서 한 번에 Top 5까지 추천 결과를 출력하도록 하고, 각각의 결과가 사용자의 질문과 어떤 부분에서 일치하거나 어긋나는지 비교했습니다. 그 과정에서 비정형적인 선호를 묻는 질문과 가격이나 인원 수처럼 명확한 조건을 요구하는 정형적인 질문 사이에 성능 차이가 있다는 것을 발견했습니다.</p>

<p>그래서 사용자의 질문을 정형 조건과 비정형 조건으로 나누어 처리하는 방식으로 로직을 개선했습니다. 예를 들어 “가격이 4만원 이하이고 너무 시끄럽지 않은 게스트하우스 추천해줘”라는 질문이 들어오면, ‘4만원 이하’는 정형 조건으로 추출하고 ‘너무 시끄럽지 않은’은 비정형 조건으로 분류합니다. 이후 가격과 같은 정형 조건에는 명확한 필터를 적용하여 4만원 이하인 숙소만 검색 대상으로 제한했습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/5679e238-946a-4d42-9802-2256a2ab67c4/image.png" alt="5" /></p>

<p>이 경험을 통해 RAG를 활용한 서비스에서는 단순히 RAG를 구축하고 답변을 생성하는 것만큼이나, “왜 이런 결과가 나왔는가?”를 분석하는 과정이 중요하다는 것을 배웠습니다.</p>

<p><br /></p>

<p><strong>Q. 문제에 대한 개선 방향은 어떤 것이 있을까요 ?</strong></p>

<p>은서 : 저희가 프로젝트를 진행하면서 마주한 문제 중 하나는 경쟁 애플리케이션인 ‘게딱지’가 먼저 출시되었다는 점입니다. 게딱지 역시 게하르방과 마찬가지로 제주도 게스트하우스를 소개하고 예약을 도와주는 서비스이기 때문에, 비슷한 목적을 가진 서비스가 먼저 시장에 나왔다는 점에서 저희만의 차별성을 더욱 명확하게 만들어야 할 필요가 있었습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/bbc19f33-e883-49c3-8da7-2fb0b19a443a/image.png" alt="6" /></p>

<p>이에 저희는 단순히 게스트하우스를 소개하고 예약할 수 있는 기능에 그치지 않고, 게하르방만의 아이덴티티를 만들기 위해 다양한 기능을 추가하고 고도화하였습니다. 먼저 스텝 지도를 제작하여 여러 게스트하우스의 스텝 모집 공고를 한눈에 확인할 수 있도록 하였습니다.</p>

<p>또한 AI 기능을 활용해 사용자가 궁금한 내용을 바로 질문할 수 있는 챗봇 서비스를 제공하고, 사용자의 조건과 취향에 맞는 게스트하우스를 추천받을 수 있도록 기능을 확장하였습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/ffe5d0f5-2c64-464f-9fdc-ffd6618408ba/image.png" alt="7" /></p>

<p>물론 경쟁 서비스가 등장했다는 이유만으로 이러한 기능들을 만든 것은 아니지만, 비슷한 서비스가 존재하는 만큼 이를 무시할 수는 없었습니다. 따라서 기존 서비스와 단순히 비슷한 앱을 만드는 것보다는 사용자가 실제로 필요로 하는 정보가 무엇인지 고민하고, 더 편리하게 이용할 수 있는 서비스를 만드는 방향으로 개선해 나갔습니다.</p>

<p>추후에는 이러한 차별성을 더욱 강화하기 위해 각 게스트하우스의 분위기와 취향, 특징을 담을 수 있는 개별 커뮤니티 공간을 만드는 것을 계획하고 있습니다. 이를 통해 단순히 숙소 정보를 확인하고 예약하는 앱을 넘어, 게스트하우스마다 가진 개성과 문화를 사용자가 미리 경험하고 서로 소통할 수 있는 서비스로 발전시키고자 합니다.</p>

<p><br /></p>

<p><strong>Q. Summer Dev 프로젝트에서 개발자로 참여한 경험을 설명해 주세요. 어떤 역할을 맡았고, 주요 기술 스택은 어떻게 구성되었나요?</strong></p>

<p>지우 : 1학기 프로젝트에서는 PM을 맡아 기획과 프로젝트 운영을 중심으로 참여했지만, 이번 Summer Dev 프로젝트에서는 제가 생각한 기획을 직접 개발해보고 싶다는 생각으로 AI 개발 역할에 도전했습니다. 처음 해보는 개발이었지만, 팀 회의 중 리뷰 기능에 AI를 적용해보자는 이야기가 나오면서 해당 기능을 직접 맡아 구현하게 되었습니다.</p>

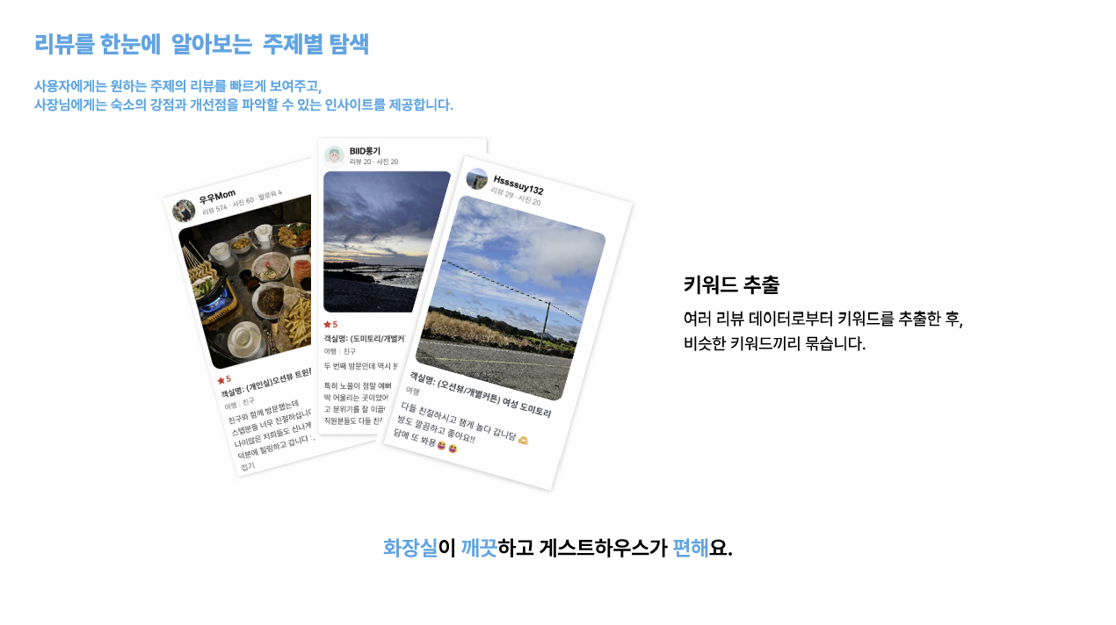
<p>리뷰 기능을 개발하면서 가장 많이 고민했던 부분은 “리뷰를 어떻게 하면 사용자에게 더 유용하게 보여줄 수 있을까?”였습니다. 그 과정에서 리뷰에서 주요 키워드를 추출하고, 사용자가 특정 키워드를 선택하면 해당 키워드가 언급된 리뷰 본문으로 바로 이동할 수 있는 기능을 기획하고 개발했습니다.</p>

<p>또한 리뷰의 긍정·부정 감정을 분석해 단순히 리뷰를 보여주는 것에서 그치지 않고, 사장님이 고객 반응을 한눈에 파악할 수 있도록 인사이트를 제공하는 기능도 추가로 구현했습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/a94db3c9-b0cf-4a16-8a6e-b5072186ec86/image.png" alt="8" /></p>

<p>개발 과정에서는 처음 접하는 부분이 많아 필요한 내용을 직접 공부하면서 하나씩 구현해 나갔습니다. 특히 코드를 작성하는 것뿐만 아니라, 어떤 기준으로 키워드를 추출하고 감정을 판단할지 등 기능의 로직을 직접 설계하는 과정이 생각보다 재미있었습니다.</p>

<p>주요 기술 스택은 Python을 중심으로 구성했습니다. 데이터 처리에는 pandas, 한국어 형태소 분석과 텍스트 전처리에는 Kiwi, 리뷰 키워드 추출에는 TF-IDF를 활용했습니다. 또한 실제 서비스와의 연동을 고려해 API 형태로 사용할 수 있도록 개발 방향을 잡았습니다.</p>

<p>이번 프로젝트를 통해 이전에는 PM의 입장에서 기능을 기획했다면, 이번에는 기획한 아이디어가 실제 기능으로 구현되는 과정까지 직접 경험할 수 있었습니다. 특히 기획과 개발을 모두 경험하면서 서비스의 기능을 조금 더 현실적으로 바라보고 설계할 수 있게 된 점이 가장 큰 경험이었습니다.</p>

<p><br /></p>

<p><strong>Q. 사용자 경험을 개선하기 위해 어떤 전략을 사용했나요?</strong></p>

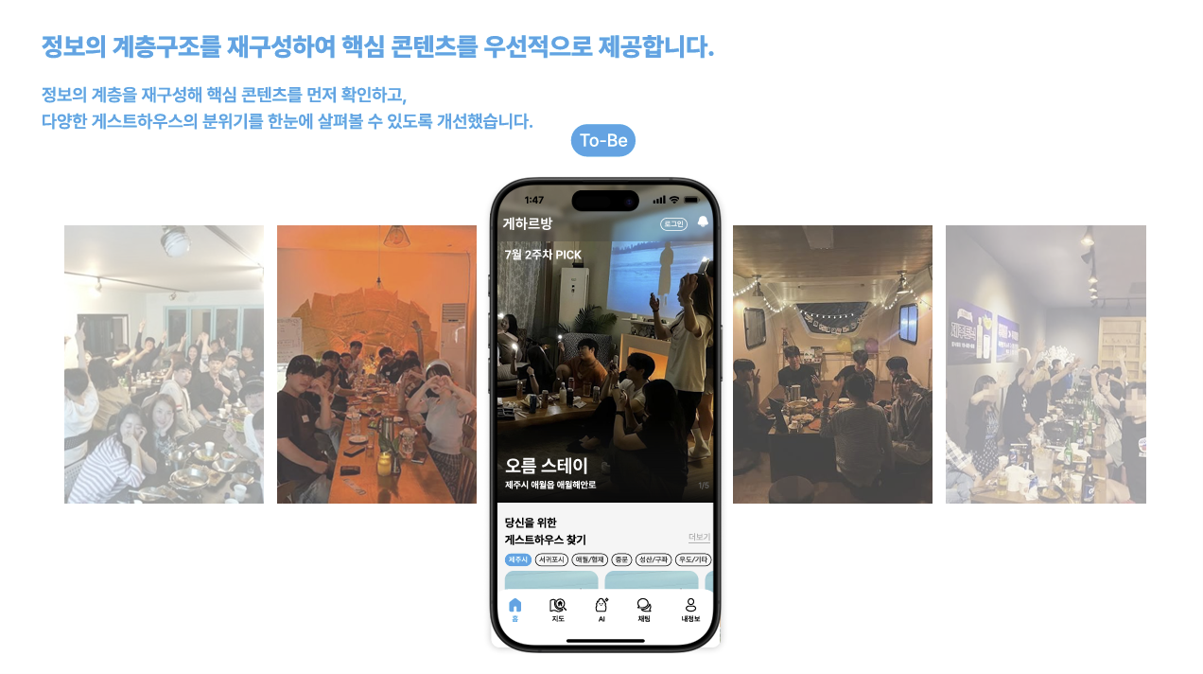
<p>요셉 : 기존 화면에서는 사용자가 어떤 행동을 취해야 하는 지 불명확 했습니다. 사용자가 서비스를 사용하자마자 이 서비스가 어떤 서비스를 제공하고, 어떤 분위기의 서비스인지 직관적으로 인지하는 것에 가장 큰 초점을 맞추고 새롭게 디자인을 진행했습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/f9b68500-64ef-4bb5-b38f-5aadcc4cc5a7/image.png" alt="9" /></p>

<p><br /></p>

<p>‘안전한 게스트하우스를 찾는다’는 너무나 당연한 소리라고 생각을 했습니다. 그래서 사용자가 여러 게스트하우스 분위기를 찾아야 하는 피로를 줄여주고, 자신에게 어울리는 혹은 이번 여행에 가보고 싶은 재주도 내 안전한 게스트하우스를 큐레이션 해주는 서비스로 사용자가 느끼는 경험을 좀 더 확장하려고 하였습니다</p>

<p><br /></p>

<p><strong>Q. 본인 팀만의 특별한 협업 방식이 있나요? 있다면 소개해 주세요.</strong></p>

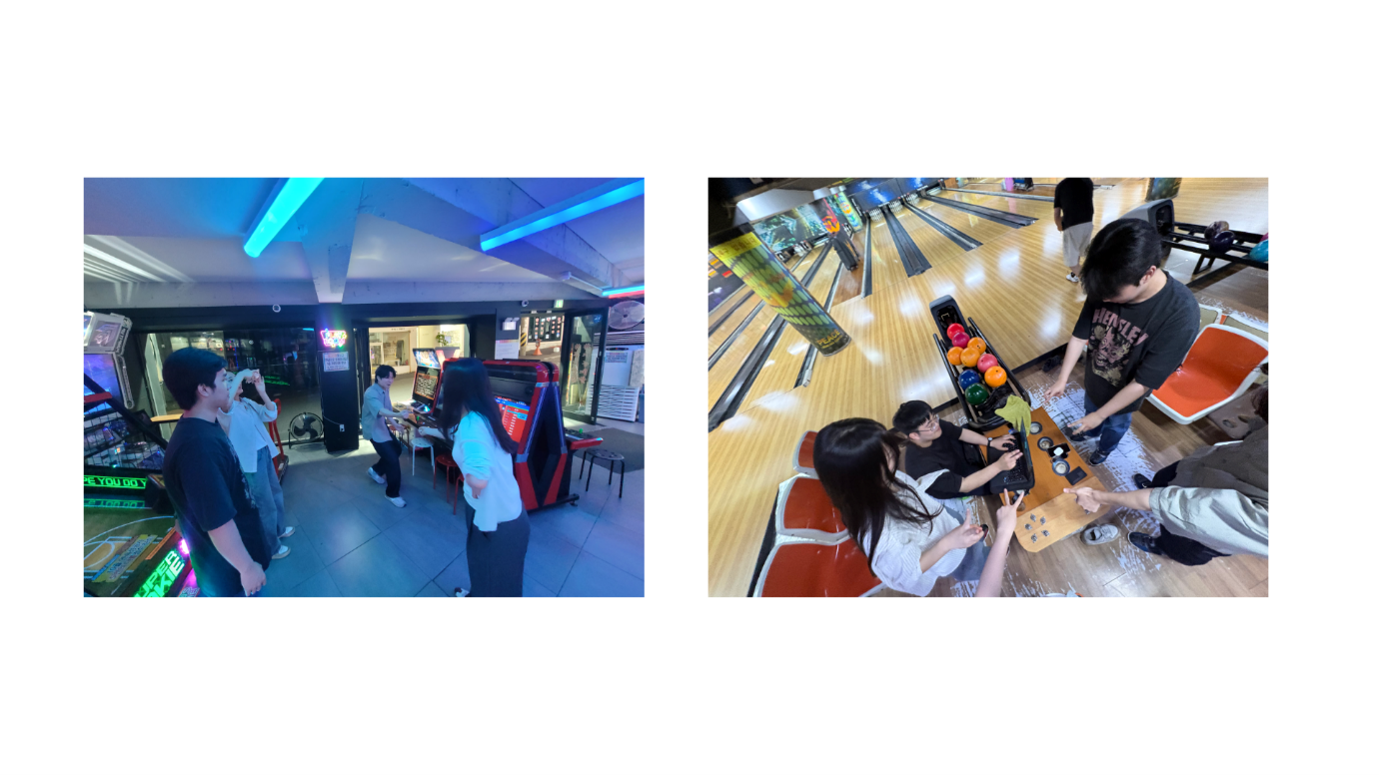
<p>성준 : 저희 팀의 특별한 협업 방식은 자주 만나고, 즐겁게 놀면서 진행했다는 점입니다.</p>

<p>저희 팀은 AICOSS 창업동아리에 소속되어 활동하면서 정기적인 회의뿐만 아니라 수시로 만나 서비스의 방향과 개발 진행 상황을 공유해왔습니다.</p>

<p>함께 보내는 시간이 많다 보니 각자의 개발 상황이나 고민을 자연스럽게 이야기할 수 있었고, 문제가 생겼을 때도 빠르게 의견을 주고받을 수 있었습니다. 또한 팀원 간의 친밀도를 높이기 위해 회의나 활동에서 정한 벌칙으로 릴스 대결을 여러 차례 진행하기도 했습니다. 함께 영상을 기획하고 촬영하는 과정에서 자연스럽게 웃고
이야기할 기회가 많아졌고, 덕분에 서로 편하게 의견을 이야기할 수 있는 팀 분위기가 만들어졌습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/02f4d669-12a0-4b16-b562-b211b21c8845/image.png" alt="10" /></p>

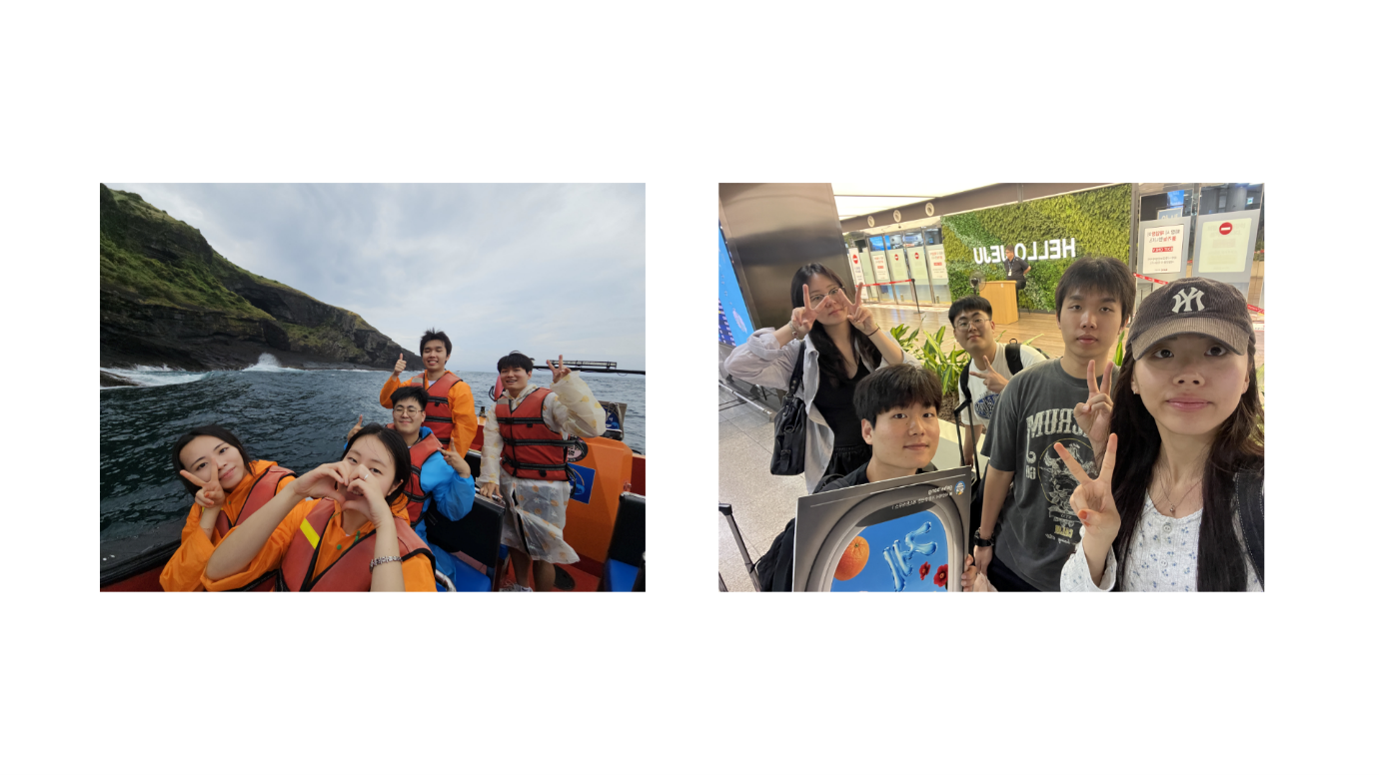
<p>특히 방학에는 단순히 회의실에서 서비스만 개발하는 데 그치지 않고, 팀원들과 직접 제주도의 게스트하우스를 방문해 실제로 숙박하고 게스트하우스 문화를 경험했습니다. 서비스를 만드는 개발자의 입장이 아니라 실제 여행객의 입장에서 숙소를 이용해보며 어떤 정보가 필요한지, 게스트하우스마다 어떤 분위기와 특징이 다른지를 함께 확인했습니다.</p>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/e6d29ed2-3002-487f-b390-950c3e11e4ae/image.png" alt="11" /></p>

<p>이 과정에서 느낀 점들을 팀원들과 공유하면서 기존 기능을 다시 바라보게 되었고, 지역 구분이나 숙소의 분위기, 테마와 같은 요소를 서비스에 어떻게 반영할지 논의할 수 있었습니다.</p>

<p><br /></p>

<p>지금까지 사용자 관점에서 서비스를 고민하며 게스트하우스 통합 플랫폼 “게하르방”을 제작한 NoBrains팀이었습니다 !</p>]]></content><author><name>sanghyeon</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] 제주도 게스트하우스 통합 플랫폼 ‘게하르방’, NoBrains팀]]></summary></entry><entry><title type="html">[2026 SUMMER DEV] AI 기반 플로깅 경로 추천 서비스 ‘플로버’, 플로버팀</title><link href="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_%ED%94%8C%EB%A1%9C%EB%B2%84.html" rel="alternate" type="text/html" title="[2026 SUMMER DEV] AI 기반 플로깅 경로 추천 서비스 ‘플로버’, 플로버팀" /><published>2026-08-27T00:00:00+09:00</published><updated>2026-08-27T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C%20%ED%9A%8C%EA%B3%A0%EB%A1%9D_%ED%94%8C%EB%A1%9C%EB%B2%84</id><content type="html" xml:base="https://jnu-econovation.github.io/summer/winter_dev/2026/08/27/%EC%8D%B8%EB%A8%B8%EB%8D%B0%EB%B8%8C-%ED%9A%8C%EA%B3%A0%EB%A1%9D_%ED%94%8C%EB%A1%9C%EB%B2%84.html"><![CDATA[<h2 id="summer-dev-ai-------">[2026 SUMMER DEV] AI 기반 플로깅 경로 추천 서비스 ‘플로버’, 플로버팀</h2>

<h3 id="section">프로젝트 소개</h3>

<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/0321bd14-52da-45e6-ae32-6ca9c5fa0202/image.png" alt="표지" /></p>

<p>플로버팀은 공공데이터를 활용한 상권 밀집도 분석을 통해 AI 기반 플로깅 경로를 추천해주는 서비스인 “플로버” 앱을 개발하였습니다.</p>

<p><br /></p>

<h3 id="section-1">팀원 소개</h3>

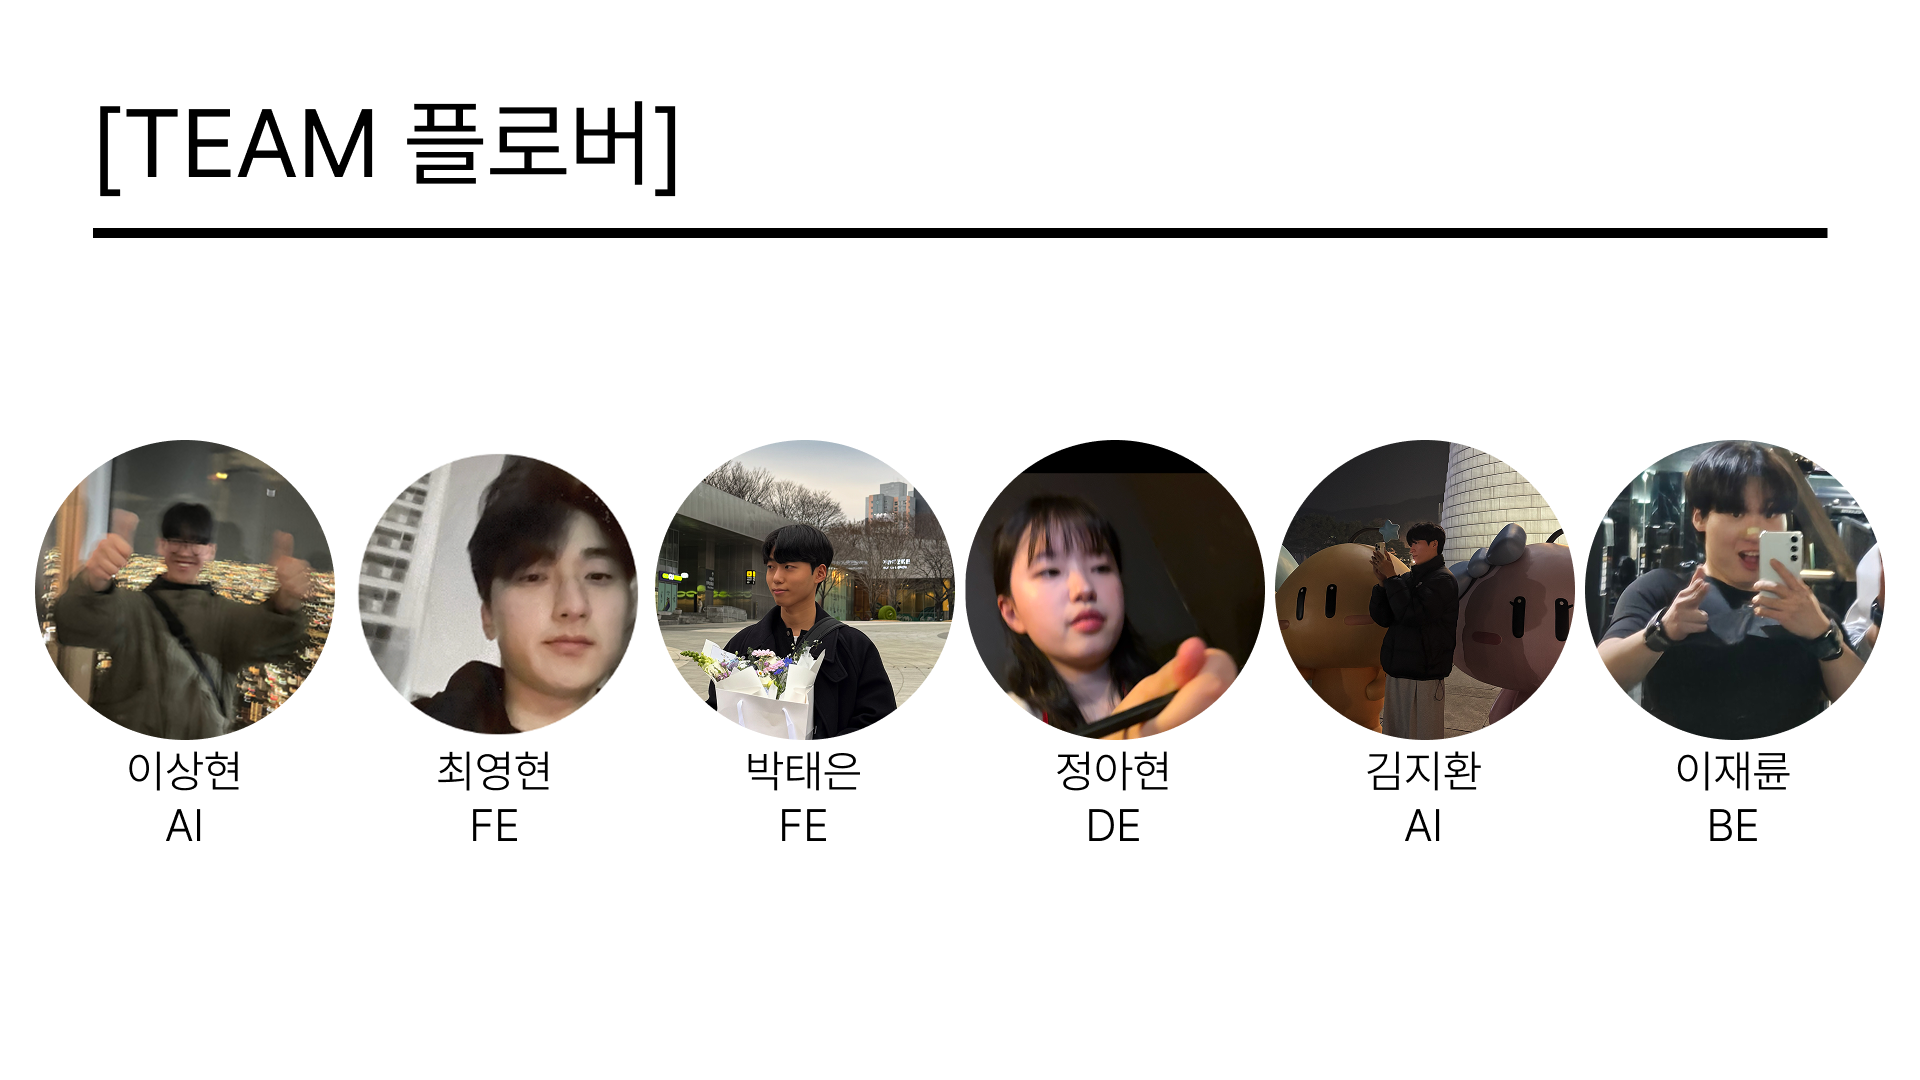
<p><img src="https://velog.velcdn.com/images/sanghyeon1225/post/0f4c3015-38cf-4820-b661-b61c28bf0ad5/image.png" alt="plover" /></p>

<p>플로버팀은 AI 상현님, AI 지환님, BE 재륜님, FE 영현님, FE 태은님, DE 아현님으로 구성되어 있습니다.</p>

<p><br /></p>

<h3 id="section-2">인터뷰</h3>

<p><strong>Q. 프로젝트를 소개해주세요!</strong></p>

<p>상현 : 저희 팀은 5 소프트웨어공학과, 1 국악학과로 이뤄진 팀입니다. 저희는 이번에 단순 서비스를 만들기 보단, 공모전과 실사용자 유치를 위한 개발을 해보기로 이야기를 했었고, 여러 도메인에서 겪는 문제들을 찾으려고 했었습니다.</p>

<p>그 과정 속에서, 플로깅하는 여러 단체에서 빈번히 말하는 쓰레기 위치를 못 찾는 문제, 초행길에 동선 짜는 문제들을 해결하고자 “플로버”라는 앱을 기획하고 개발하게 되었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 하면서 어떤 문제를 겪었나요?</strong></p>

<p>상현 : 기획을 하는데 있어서 가장 큰 어려움을 겪었던 것 같습니다. 어떤 도메인으로 할지, 어떤 가치를 사용자에게 제공할지 고민하는 과정이 3주 가량 이어졌었고, 간신히 환경 도메인과 관련된 플로깅 서비스를 기획하게 됐었습니다.</p>

<p>플로깅 서비스를 기획하면서도 사용자들에게 어떤 가치를 제공해줄지 많은 논의가 이뤄졌습니다. 저는 사용자들로부터 데이터를 수집해서 추후 경로 추천 기능을 발전시킬 방법을 추가하고 싶었으나, 플로깅 하는 과정에서 사용자가 어떤 쓰레기를 주웠는지 그때 그때 기록하는게 사용자 친화적이지 않다는 팀간의 논의에 따라 해당 기능이 기각 됐었습니다.</p>

<p>하지만 이걸 다른 방향성으로 전환했었는데요, 플로깅을 하고 있지 않는 사용자가 길거리에 떨어진 쓰레기를 제보하는 기능을 도입하여, 사용자가 제보한 위치, 쓰레기의 종류와 갯수를 분류하여 DB에 저장하는 방식을 사용했었습니다.</p>

<p>덕분에 팀 내부 큰 불화 없이 서로가 추구하는 문제 해결 방법을 채택할 수 있었습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 하기 전 후 달라진 점이 있다면?</strong></p>

<p>상현 : 서비스를 바라보는 관점을 다르게 가지게 된 것 같습니다.</p>

<p>그 전까지 진행했던 프로젝트는 근거 없이 무작정 기획, 개발을 하는 프로세스로 이뤄졌었습니다.
그러나 이번에는 6명이라는 인원이 모인 만큼 문제 파악, 원인 분석, 관계자 인터뷰, 경쟁사 조사 등을 앞서 진행해서 체계적으로 프로젝트를 이끌어나갈 수 있었습니다.</p>

<p>특히 이번 프로젝트에서 팀장을 맡으면서 개발뿐만 아니라 PM 역할도 비슷하게 했던 것 같습니다. 아현님이 많은 도움을 주셨지만 팀원들 일정 조율이나 프로젝트 진행 관리하는게 많이 힘들었던 것 같아요. 그치만 단순 기능 개발에서 멈추지 않고, 여러 경험을 해보면서 저만의 가치를 쌓아가는 경험을 했던 것 같아서 많은걸 얻어갈 수 있는 한 학기였습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트를 시작하는 팀에게 전해줄 꿀팁을 말해주세요!</strong></p>

<p>상현 : 저는 후배들에게 항상 이 말을 전해주고 싶었어요. 자신이 흥미를 잃지 않고 끝까지 즐길 수 있는 프로젝트를 했으면 좋겠습니다.</p>

<p>내가 재밌어하는 주제가 아니라면 프로젝트 중반을 넘어갈 때, 흥미를 잃기 시작하게 되더라구요. 그러다가 번아웃이 오고 프로젝트에 적극적으로 임하지 않게도 되고…</p>

<p>그래서 기획을 하는 단계에서 팀원들과 자신이 이루고자 하는 방향과 가치를 명확하게 말하고, 팀원들 간 조율이 진행된 상황에서 프로젝트를 진행했으면 좋겠습니다.</p>

<p>누군가는 제품 출시를 통해 사용자 유치 경험을 해보고 싶을 수도 있고, 누구는 서비스 출시보다는 깊게 기술적인 고민과 공부를 하면서 진행하고 싶을 수도 있고, 누구는 돈을 벌 수 있는 프로젝트를 여러개 하고 싶을 수도 있을거에요.</p>

<p>이런 점들을 우선 스스로 생각을 해서 메타인지가 된 상태로, 팀원들과 이야기를 하면 좀 더 좋은 프로젝트를 할 수 있지 않을까 !!!!!!! 싶습니다.</p>

<p>다들 포기하지말고 항상 웃으면서 즐기면서 개발했으면 좋겠어요 !!</p>

<p><br /></p>

<p><strong>Q. Summer Dev 프로젝트에서 개발자로 참여한 경험을 설명해 주세요. 어떤 역할을 맡았고, 주요 기술 스택은 어
떻게 구성되었나요?</strong></p>

<p>영현 : 플로버 프로젝트에서 프론트엔드 개발자로 참여해 기획과 디자인을 실제 앱 화면으로 구현하고, 사용자 흐름과 UI 완성도를 높이는 역할을 맡았습니다.</p>

<p>React Native, Expo, TypeScript를 활용해 주요 기능과 재사용 가능한 컴포넌트를 개발했으며, iOS 환경에서 발생하는 화면 및 동작 문제를 점검하고 개선했습니다.</p>

<p>또한 iOS 빌드와 TestFlight 테스트부터 App Store 심사 대응 및 최종 배포까지 담당하며 앱 개발의 전 과정과 실제 출시 경험을 쌓았습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 개발 중 어려움을 겪은 경험이 있나요? 어떻게 해결했으며, 그 과정에서 얻은 교훈은 무엇인가요?</strong></p>

<p>태은 : 프로젝트에서 가장 어려웠던 점은 React Native와 Expo를 처음 사용하는 상황에서, 앱이 백그라운드로 전환되어도 플로깅 경로와 걸음 수를 정확하게 기록하는 것이었습니다.</p>

<p>처음에는 expo-location의 watchPositionAsync와 Pedometer를 사용했습니다. 하지만 화면을 끄거나 다른 앱을 실행하면 위치 추적과 타이머 갱신이 중단되어 이동 경로가 누락됐습니다. 앱으로 돌아왔을 때 시간이 달라지거나, 만보기의 누적값이 중복 반영되는 문제도 발생했습니다. GPS 오차 때문에 실제로 움직이지 않았는데도 이동 거리가 증가하기도 했습니다.</p>

<p>이를 해결하기 위해 Expo 공식 문서와 예제를 참고하며 앱 생명주기와 백그라운드 Task의 동작 방식을 학습했습니다. 이후 expo-task-manager와 expo-location으로 백그라운드 위치 추적을 구현했습니다. 수집한 좌표는 React 상태에만 두지 않고 expo-file-system을 이용해 세션 스냅샷으로 저장했습니다. 앱이 다시 활성화되면 아직 반영되지 않은 좌표만 불러오도록 하여 데이터 누락과 중복을 방지했습니다.</p>

<p>데이터 정확도를 높이기 위한 보정도 적용했습니다. 정확도가 30m보다 낮은 GPS 좌표와 이전 위치에서 2m 미만으로 이동한 좌표는 제외하고, 유효한 좌표 사이의 거리는 Haversine 공식으로 계산했습니다. 타이머는 setInterval의 실행 횟수가 아니라 시작 시각과 누적 휴식 시간을 기준으로 계산해 백그라운드 전환 후에도 실제 시간과 일치하도록 했습니다. 걸음 수 역시 Pedometer의 누적값을 그대로 더하지 않고 이전 값과의 차이만 반영했으며, iOS에서는 백그라운드에 있었던 구간의 걸음 수를 별도로 조회해 보정했습니다.</p>

<p>백엔드 연동에서는 촬영한 인증 사진과 경로 지도 이미지를 presigned URL로 S3에 먼저 업로드했습니다. 이후 로컬 URI가 아닌 업로드에 성공한 이미지 URL과 이동 경로, 거리, 걸음 수, 운동 시간 등을 플로깅 완료 API에 전달했습니다. 또한 권한이 거부되거나 백그라운드 Task를 지원하지 않는 환경에서는 foreground 추적으로 전환해 앱이 중단되지 않도록 처리했습니다.</p>

<p>이 경험을 통해 모바일 프론트엔드는 화면 구현뿐 아니라 앱 생명주기, 운영체제별 권한, 센서 데이터의 오차와 네트워크 실패까지 고려해야 한다는 것을 배웠습니다. 또한 새로운 기술을 사용할 때 기능을 작은 단위로 나누고 실제 기기에서 검증하며 점진적으로 개선하는 것이 중요하다는 점을 배웠습니다.</p>

<p><br /></p>

<p><strong>Q. 프로젝트 팀 내에서 코드 리뷰 및 테스트 프로세스는 어떻게 이루어졌나요? 코드 품질과 안정성을 유지하기 위
해 어떤 노력을 기울였나요?</strong></p>

<p>재륜 : 저희 팀은 GitHub PR과 단위 및 통합 테스트를 통해 코드를 검증했고, 코드 가독성과 일관성을 유지하기 위해 AGENTS.md와 Skills를 활용해 프로젝트의 개발 규칙을 관리했습니다. 특히 개발 과정에서 발생했던 오류나 잘못된 구현 방식은 그때그때 문서에 추가해, 이후 같은 실수가 반복되지 않도록 했습니다.</p>

<p>또한 단순히 현재 개발을 위한 문서화에 그치지 않고, API 동작 방식, 주요 설계 결정, 트러블슈팅 과정 등 프로젝트 전반에 대한 문서화를 지속적으로 진행했습니다. 이후 다른 개발자가 프로젝트를 유지보수하거나 인수인계를 받을 때 기존 코드와 설계 의도를 빠르게 파악할 수 있도록 하는 것까지 고려했습니다.</p>

<p>최근에 다른 사람이 개발해둔 프로젝트를 직접 유지보수할 일이 있었는데, 그 과정에서 문서화의 중요성을 크게 느꼈습니다. 문서가 부족하면 작은 기능 하나를 수정하기 위해서도 기존 코드의 구조와 개발자의 의도를 파악하는 데 많은 시간이 들지만, 설계 이유나 문제 해결 과정이 잘 남아 있으면 그 시간을 크게 줄일 수 있었습니다.</p>

<p>그래서 이번 프로젝트에서는 문서화를 단순한 기록이 아니라 코드 품질의 일부라고 생각했습니다. 문서 작성에 당장은 시간이 들더라도, 장기적으로는 유지보수와 인수인계 시간을 줄이고 같은 문제를 다시 분석하는 비용을 줄일 수 있기 때문에 결과적으로 개발 비용 절감에도 도움이 된다고 생각합니다.</p>

<p><br /></p>

<p><strong>Q. 문제에 대한 개선 방향은 어떤 것이 있을까요?</strong></p>

<p>지환 : 프로젝트를 시작하기 전까지는 Java와 Spring을 이용한 백엔드 개발을 주로 공부했습니다. 머신러닝이나 GIS는 거의 처음 접하는 분야였기 때문에, 초반에는 모델을 만드는 것보다 데이터가 어떤 특성을 갖는지 이해하는 것부터 쉽지 않았습니다. 예를 들어 쓰레기 제보 데이터는 제보된 위치는 확실한 쓰레기 발생 지점이라고 볼 수 있지만, 제보가 없는 지역을 모두 깨끗한 지역이라고 단정할 수 없었습니다.</p>

<p>이 문제를 해결하기 위해 PU-Learning을 공부했고, 처음 사용했던 Random Forest에서 XGBoost로 모델을 변경한 뒤 편의점, 상권, 도로 특성처럼 실제 환경과 관련 있는 피처를 하나씩 추가하며 결과를 비교했습니다. 그 과정에서 Recall을 71.4%에서 88.86%까지 높일 수 있었습니다.</p>

<p>모델을 만드는 것보다 더 어려웠던 건 이 결과를 실제 서비스 규모로 가져가는 일이었습니다. 광주 일부 지역에서 잘 돌아가던 코드를 전국 단위로 확장하니 10m 격자만 1억 개가 넘었고, 공간 조인 과정에서 메모리가 부족해 프로세스가 계속 종료됐습니다. 처음에는 서버 사양의 문제라고 생각했지만, 데이터를 한꺼번에 메모리에 올리는 구조 자체가 문제였습니다. 이후 지역을 일정 크기로 나눠 처리하고, 피처 추출과 DB 적재도 청크 단위로 수행하도록 바꾸면서 전국 데이터를 처리할 수 있도록 만들었습니다. 이 과정에서 메모리 사용량이나 I/O 같은 부분도 실제 서비스에서는 중요한 설계 요소라는 걸 많이 배웠습니다.</p>

<p>또 하나 많이 배운 부분은 각 기능을 따로 구현하는 것과 실제 서비스로 연결하는 것은 완전히 다른 문제라는 점이었습니다. 모델이 만든 예측값을 PostGIS에 저장하고, 이를 OSM 도로 데이터와 공간 조인한 뒤 GraphHopper의 경로 가중치로 사용했습니다. 지도에서는 같은 데이터를 그대로 보내는 대신 H3와 PMTiles 형태로 가공해 서비스하도록 구성했습니다. 개발 도중에는 모델 추론과 DB 적재가 하나로 묶여 있어서 DB 오류가 발생할 때마다 긴 추론을 처음부터 다시 해야 하는 문제도 있었는데, 두 과정을 분리해 필요한 단계만 다시 실행할 수 있도록 구조를 바꾸기도 했습니다.</p>

<p>이 프로젝트를 하면서 가장 많이 달라진 점은 제가 익숙한 기술 안에서만 해결책을 찾지 않게 된 것입니다. 처음에는 백엔드 개발만 해왔지만, 실제 문제를 해결하려다 보니 머신러닝, 공간 데이터 처리, 데이터베이스, 라우팅, 대용량 데이터 처리까지 자연스럽게 영역이 넓어졌습니다. 새로운 기술을 많이 사용했다는 것 자체보다, 문제가 생겼을 때 원인을 찾아보고 필요한 기술을 공부한 뒤 직접 적용하고 다시 결과를 확인하는 과정을 반복해본 경험이 가장 큰 성장이라고 생각합니다.</p>

<p><br /></p>

<p><strong>Q. 사용자 경험을 개선하기 위해 어떤 전략을 사용했나요?</strong></p>

<p>아현 : 우선 저희 앱을 사용하시는 분들은 당장 플로깅을 하기 위해서 사용하실 것이라는 가정을 두었습니다. 그래서 처음에 강하게 의견을 냈던 부분은 ‘앱을 실행하자마자 플로깅 시작 버튼을 누를 수 있어야 한다.’ 였고요.</p>

<p>플로깅을 하면서 앱 사용이 불편하지 않도록 하는 것도 중요한 지점이라, 초기에 기획했던 ‘줍’버튼. 쓰레기를 주울 때 마다 카운트를 세는 버튼은 과감하게 삭제 하였습니다. 사유는 쓰레기를 주우려면 장갑을 끼거나 집개를 잡아야 하는데, 양 손을 쓰는 과정에서 줍버튼을 누르는 것은 너무 번거롭다는 것이었습니다.</p>

<p>그리고 사용자 경험을 고려하기 위해 사전에 심층 인터뷰를 3건, 설문조사를 63건 가량 받은 것도 전략중에 하나였던 것 같습니다. 저희 팀은 당시 플로깅에 대한 지식이 전무한 상황이었어서 인터뷰 과정이 크게 도움이 되었던 것 같습니다.</p>

<p><br /></p>

<p>지금까지 환경을 생각하는 서비스 “플로버”를 개발한 플로버팀이었습니다!</p>]]></content><author><name>sanghyeon</name></author><category term="SUMMER/WINTER_DEV" /><category term="dev" /><summary type="html"><![CDATA[[2026 SUMMER DEV] AI 기반 플로깅 경로 추천 서비스 ‘플로버’, 플로버팀]]></summary></entry><entry><title type="html">트랜스포머 디코더로 GPT-2 구조 이해하기</title><link href="https://jnu-econovation.github.io/tech/2026/08/26/%ED%8A%B8%EB%9E%9C%EC%8A%A4%ED%8F%AC%EB%A8%B8-%EB%94%94%EC%BD%94%EB%8D%94-%EB%AA%A8%EB%8D%B8%EB%A1%9C-%ED%85%8D%EC%8A%A4%ED%8A%B8-%EC%83%9D%EC%84%B1%ED%95%98%EA%B8%B0.html" rel="alternate" type="text/html" title="트랜스포머 디코더로 GPT-2 구조 이해하기" /><published>2026-08-26T00:00:00+09:00</published><updated>2026-08-26T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/tech/2026/08/26/%ED%8A%B8%EB%9E%9C%EC%8A%A4%ED%8F%AC%EB%A8%B8%20%EB%94%94%EC%BD%94%EB%8D%94%20%EB%AA%A8%EB%8D%B8%EB%A1%9C%20%ED%85%8D%EC%8A%A4%ED%8A%B8%20%EC%83%9D%EC%84%B1%ED%95%98%EA%B8%B0</id><content type="html" xml:base="https://jnu-econovation.github.io/tech/2026/08/26/%ED%8A%B8%EB%9E%9C%EC%8A%A4%ED%8F%AC%EB%A8%B8-%EB%94%94%EC%BD%94%EB%8D%94-%EB%AA%A8%EB%8D%B8%EB%A1%9C-%ED%85%8D%EC%8A%A4%ED%8A%B8-%EC%83%9D%EC%84%B1%ED%95%98%EA%B8%B0.html"><![CDATA[<p>지난 시간에는 트랜스포머 인코더를 활용해 텍스트를 분류하는 방법을 알아봤습니다.
이번 시간에는 텍스트 생성에 뛰어난 <strong>트랜스포머 디코더</strong>의 원리를 살펴보고,
GPT-2 Base와 유사한 구조의 언어 모델을 직접 구현해보겠습니다.</p>

<p><br /></p>

<h2 id="section">1. 원본 트랜스포머의 디코더</h2>

<p>원본 트랜스포머는 입력된 문장을 <strong>인코더</strong>에 넣어 문장의 의미를 표현하고
이전까지 생성한 단어와 문장의 의미를 가지고 <strong>디코더</strong>가 다음 단어를 예측하는 구조입니다</p>

<p>예를 들어 영어 문장을 한국어로 번역한다고 가정을 하면
먼저 인코더가 영어 문장을 읽고 단어들의 관계와 문장의 의미를 벡터로 표현합니다
그 다음 디코더는 인코더가 만든 정보를 참고하면서 번역 문장을 한 토큰씩 생성합니다</p>

<p>이때 디코더는 다음 두 정보를 함께 이용합니다.</p>

<ol>
  <li>인코더가 이해한 영어 문장의 의미</li>
  <li>지금까지 생성한 토큰의 정보</li>
</ol>

<p>이렇게 원본 트랜스포머 디코더는 이를 위해 크게 두 종류의 어텐션이 있습니다</p>

<ul>
  <li><strong>마스크드 셀프 어텐션</strong>: 이전까지 나온 출력 토큰들의 관계를 확인합니다.</li>
  <li><strong>크로스 어텐션</strong>: 인코더가 처리한 입력 문장의 정보를 확인합니다.</li>
</ul>

<p><br /></p>

<h2 id="gpt----">2. GPT와 같은 디코더 전용 모델</h2>

<p>GPT 계열 모델은 원본 트랜스포머에서 인코더를 사용하지 않고 
주로 <strong>디코더 구조만 사용</strong>합니다</p>

<blockquote>
  <p>프롬프트 → 디코더 → 다음 토큰 예측 → 예측 결과를 다시 입력 → 다음 토큰 예측</p>
</blockquote>

<p>이러한 방식을 <strong>자기회귀 생성, Autoregressive Generation</strong>이라고 합니다</p>

<p>이러한 디코더 언어 모델은 현재까지 입력된 토큰을 보고 
바로 다음 토큰을 맞히도록 학습을 합니다</p>

<p>예를 들어 학습 문장이 “나는 학교에 간다” 를 학습시켜본다고 해보겠습니다
그러면 모델의 입력과 정답은 한 칸씩 밀려 있습니다</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">입력 토큰</th>
      <th style="text-align: center">맞혀야 하는 다음 토큰</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">나는</td>
      <td style="text-align: center">학교에</td>
    </tr>
    <tr>
      <td style="text-align: center">나는 학교에</td>
      <td style="text-align: center">간다</td>
    </tr>
    <tr>
      <td style="text-align: center">나는 학교에 간다</td>
      <td style="text-align: center">문장 종료</td>
    </tr>
  </tbody>
</table>

<p>실제 학습에서는 문장 전체를 한꺼번에 넣지만, 개념적으로는</p>

<blockquote>
  <p>입력: 나는 학교에 간다<br />
정답: 학교에 간다 [종료]</p>
</blockquote>

<p>이를 <strong>시프트된 타깃, Shifted Target</strong> 이라고 합니다</p>

<p>모델은 자신이 예측한 토큰과 실제 다음 토큰의 차이를 계산하고
실제 정답의 확률이 높아지도록 학습을 진행합니다</p>

<p>또한 일반적인 지도학습에서는 사람이 직접 정답 레이블을 만들어야 하지만
특별히 언어 모델에서는 텍스트 자체로부터 입력과 정답을 자동으로 만들 수 있습니다</p>

<p>사람이 별도의 정답을 작성하지 않아도 
원래 문장에서 다음 토큰을 정답으로 가져올 수 있습니다</p>

<p>이처럼 <strong>데이터 자체에서 학습에 필요한 정답을 만들어 사용하는 방식</strong>을
<strong>자기지도 학습(Self-supervised Learning)</strong>이라고 합니다.</p>

<p><br /></p>

<h2 id="section-1">3. 코잘 언어 모델링</h2>

<p>여기서 <strong>코잘 언어 모델링</strong>이라는 개념이 나오는데
인과적 언어 모델링, Causal Language Modeling이라고 부릅니다</p>

<p>핵심은 현재 토큰을 예측할 때 이전 토큰만 볼 수 있고
미래 토큰은 볼 수 없다는 개념입니다</p>

<p>예를 들어 “나는 오늘 학교에 갔다”라는 문장이 있다고 합시다
이때에 <code class="language-plaintext highlighter-rouge">학교에</code> 라는 토큰을 처리할 때 볼 수 있는 범위는 “나는 오늘 학교에” 입니다
이를 확률로 표현하면 다음과 같습니다</p>

<blockquote>
  <p>P(문장)<br />
= P(나는)<br />
× P(오늘 | 나는)<br />
× P(학교에 | 나는, 오늘)<br />
× P(갔다 | 나는, 오늘, 학교에)</p>
</blockquote>

<p>각 토큰은 현재 위치까지의 토큰들을 조건으로 다음 토큰의 확률을 계산합니다.</p>

<p>그런데 이런 생각이 들 수 있습니다 왜 마스크드 멀티 헤드 어텐션이 필요할까?</p>

<p>일반적인 셀프 어텐션에서는 문장의 모든 토큰이 서로를 볼 수 있습니다
그래서 마스크가 없다면 학교에를 처리할 때 뒤에 있는 정답인 갔다까지 볼 수 있습니다
실제 문장 생성 확인에서 미래 단어가 존재하지 않으므로 잘못된 학습이 됩니다</p>

<p>예를 들어 마스크가 없는 경우는 모든 토큰을 볼 수 있지만
코잘 마스크를 적용한 경우 한정적으로 볼 수 있게 됩니다</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">현재 토큰</th>
      <th style="text-align: center">볼 수 있는 토큰</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">나는</td>
      <td style="text-align: center">나는</td>
    </tr>
    <tr>
      <td style="text-align: center">오늘</td>
      <td style="text-align: center">나는, 오늘</td>
    </tr>
    <tr>
      <td style="text-align: center">학교에</td>
      <td style="text-align: center">나는, 오늘, 학교에</td>
    </tr>
    <tr>
      <td style="text-align: center">갔다</td>
      <td style="text-align: center">나는, 오늘, 학교에, 갔다</td>
    </tr>
  </tbody>
</table>

<p>이를 행렬로 표현하면 다음과 같은 삼각형 구조가 됩니다.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Query / Key</th>
      <th style="text-align: center">나는</th>
      <th style="text-align: center">오늘</th>
      <th style="text-align: center">학교에</th>
      <th style="text-align: center">갔다</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">나는</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
    </tr>
    <tr>
      <td style="text-align: center">오늘</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
    </tr>
    <tr>
      <td style="text-align: center">학교에</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">X</td>
    </tr>
    <tr>
      <td style="text-align: center">갔다</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">O</td>
      <td style="text-align: center">O</td>
    </tr>
  </tbody>
</table>

<p>이러한 마스크를 우리는 <strong>코잘 마스크 또는 미래 마스크</strong>라고 합니다
정확히는 미래 위치의 어텐션 점수에 매우 작은 값인 음의 무한대에 가까운 값을 더합니다
그 후 소프트맥스 함수를 적용하면 해당 위치의 어텐션 확률이 사실상 0이 됩니다</p>

<p>이렇게 하나의 어텐션만 사용하는 것이 아니라 여러 개의 어텐션 헤드를 동시에
사용하는데 각 헤드는 문장에서 서로 다른 관계에 집중할 수 있습니다</p>

<p>예를 들어 “성준은 준현에게 책을 주었다” 라는 문장이 있다면</p>

<p>각 헤드는 다음처럼 다른 관계를 학습할 수 있습니다</p>

<ul>
  <li>헤드 1: 성준 ↔ 주었다 — 주어와 서술어 관계</li>
  <li>헤드 2: 준현에게 ↔ 주었다 — 대상과 행동 관계</li>
  <li>헤드 3: 책을 ↔ 주었다 — 목적어와 행동 관계</li>
</ul>

<p>따라서 <strong>마스크드 멀티 헤드 어텐션</strong>은 
여러 관점에서 토큰 사이의 관계를 분석하고
미래 토큰은 보지 못하게 제한을 합니다</p>

<p><br /></p>

<h2 id="section-2">4. 학습할 때와 생성할 때의 차이</h2>

<p>학습할 때에는 정답 문장 전체가 이미 존재합니다
하지만 코잘 마스크를 사용하기 때문에 각 토큰은 미래 토큰을 볼 수 없습니다.</p>

<p>생성할 때에는 미래의 문장이 아직 없으므로 실제로 한 토큰씩 생성을 하게 됩니다
따라서 일반적으로 학습은 병렬처리가 가능하지만
생성은 앞 토큰의 결과가 필요하므로 순차적으로 진행되게 됩니다</p>

<blockquote>
  <p>트랜스포머 디코더는 마스크드 멀티 헤드 어텐션을 사용해 미래의 정답을 보지 않고,
이전 토큰들의 관계만 분석하면서 다음 토큰을 예측하도록 학습합니다.</p>
</blockquote>

<p>그러면 이제는 패딩 마스크와 코잘 마스크를 결합해서 모델이 의미 없는 패딩 토큰과
아직 등장하지 않은 미래 토큰을 모두 참조하지 못하도록 
최종 어텐션 마스크를 만들어보겠습니다</p>

<p>코잘 마스킹은 입력되는 토큰의 값과 무관하며, 토큰의 길이에 따라 달라집니다
입력되는 토큰의 개수가 10개이면 (10,10) 크기의 마스크 행렬을 만들어야 합니다</p>

<p>그러면 먼저 마스크 행렬을 하나 만들어 
행렬의 주 대각선 위쪽에 있는 모든 값을 0으로 만들어보겠습니다</p>

<pre><code class="python">
import keras
from keras import layers
import keras_nlp

def make_causal_mask(seq_len):
  n_hori = keras.ops.arange(seq_len)
  n_vert = keras.ops.expand_dims(n_hori,axis=1)
  mask = n_vert &gt;= n_hori
  return mask
</code></pre>

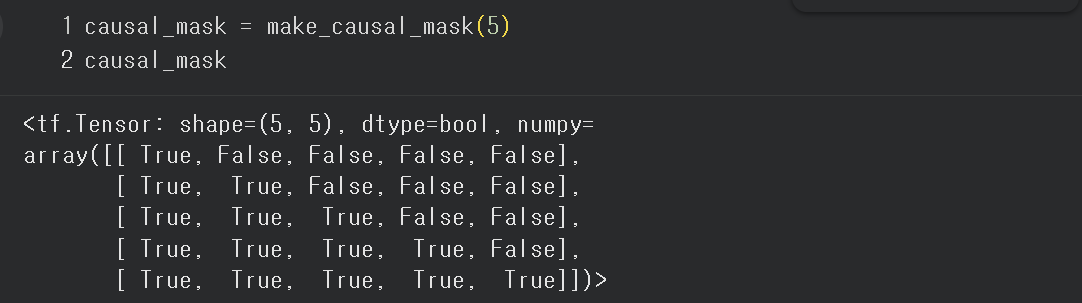
<p>여기에서는 <code class="language-plaintext highlighter-rouge">expand_dims()</code> 함수를 활용해서 2차원 텐서를 바뀐 후 
비교 연산을 통해서 결과를 얻게 됩니다</p>

<p><img src="https://velog.velcdn.com/images/newkid0714/post/389ae3e2-1a1b-4bed-adad-217765b3f4ca/image.png" alt="길이 5의 코잘 마스크 행렬" width="800" /></p>

<p>최대 시퀀스 길이가 5이고 실제 토큰이 3개라면 패딩 마스크는 [1, 1, 1, 0, 0]이 됩니다</p>

<p>여기서 앞의 세 위치는 실제 토큰이고 네 번째와 다섯 번째 위치는 길이를 맞추기 위해 추가한 패딩 토큰입니다 따라서 모든 토큰이 네 번째와 다섯 번째 패딩 위치를 참조하지 못하도록 가려야 합니다</p>

<p>코잘 마스크는 미래 토큰을 가리고 패딩 마스크는 실제 내용이 없는 패딩 토큰을 가립니다 두 마스크는 서로 다른 역할을 하므로 최종 어텐션 마스크에서는 두 조건을 함께 적용해야 합니다</p>

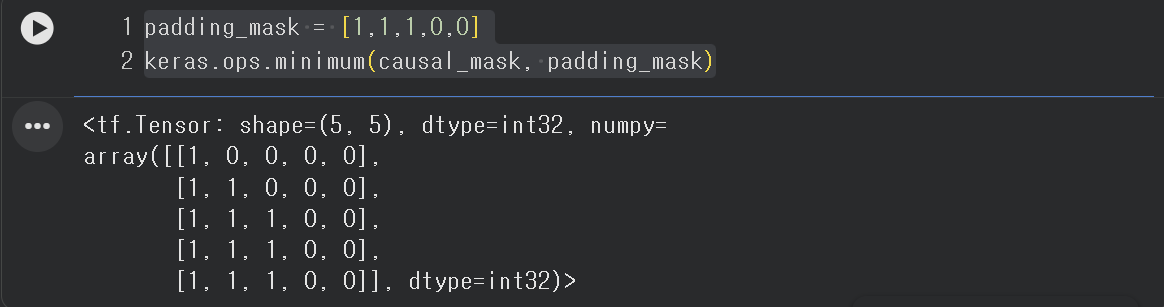
<p>이렇게 코잘 마스크와 패딩 마스크를 합치는 간단한 방법은 
<code class="language-plaintext highlighter-rouge">keras.ops.minimum()</code> 함수를 사용하는 것입니다.</p>

<pre><code class="python">
padding_mask = [1,1,1,0,0]
keras.ops.minimum(causal_mask, padding_mask)
</code></pre>
<p>해당 함수를 사용하면 위에서 만들었던 causal_mask의 불리언 값을
0과 1로 변환하여 각 행마다 padding_mask와 비교합니다</p>

<p><img src="https://velog.velcdn.com/images/newkid0714/post/b7f6003f-64aa-4d25-b1da-7154016527f7/image.png" alt="코잘 마스크와 패딩 마스크를 결합한 결과" width="800" /></p>

<p>마지막으로는 배치 차원을 고려하여 최종 어텐션 마스크를 만드는 함수
<code class="language-plaintext highlighter-rouge">make_attention_mask()</code> 를 살펴보겠습니다</p>

<pre><code class="python">
def make_attention_mask(padding_mask):
  # padding_mask의 크기가 (2,5)라고 가정
  batch_size, seq_len = keras.ops.shape(padding_mask)
  # causal_mask의 크기는 (5,5)가 된다
  causal_mask = make_causal_mask(seq_len)
  # 배치 차원을 추가해 (2,5,5)로 만든다
  causal_mask = keras.ops.broadcast_to(
      causal_mask, (batch_size, seq_len, seq_len))
  # 브로드캐스팅을 위해 padding_mask의 크기를 (2,1,5)로 
  padding_mask = keras.ops.expand_dims(padding_mask, axis=1)
  return keras.ops.minimum(causal_mask,padding_mask)
</code></pre>

<p>쉽게 이해하기 위해서 <code class="language-plaintext highlighter-rouge">padding_mask</code>의 크기를 <code class="language-plaintext highlighter-rouge">(2,5)</code>라고 가정하겠습니다</p>

<p>이는 하나의 배치에 문장 2개가 들어 있고, 
각 문장의 최대 토큰 길이가 5개라는 의미입니다
마스크에서 1은 실제 토큰, 0은 패딩 토큰을 나타냅니다</p>

<p>예를 들어 패딩 마스크가 다음과 같습니다</p>

<pre><code class="text">
[ 
[1, 1, 1, 0, 0], 
[1, 1, 1, 1, 0] 
]
</code></pre>

<p>첫 번째 문장은 실제 토큰이 3개이고, 뒤의 2개는 패딩 토큰이고
두 번째 문장은 실제 토큰이 4개이고 마지막 1개가 패딩 토큰입니다</p>

<p><code class="language-plaintext highlighter-rouge">batch_size, seq_len = keras.ops.shape(padding_mask)</code></p>

<p><code class="language-plaintext highlighter-rouge">padding_mask</code>의 크기가 <code class="language-plaintext highlighter-rouge">(2,5)</code>이므로 <code class="language-plaintext highlighter-rouge">batch_size</code>는 2
<code class="language-plaintext highlighter-rouge">seq_len</code>은 5가 됩니다 그 다음 길이가 5인 시퀀스에 적용할 코잘 마스크를 생성합니다</p>

<p><code class="language-plaintext highlighter-rouge">seq_len</code>이 5이므로<code class="language-plaintext highlighter-rouge">(5,5)</code> 크기의 코잘 마스크가 생성됩니다</p>

<p>행은 정보를 찾으려는 현재 토큰인 query의 위치를 의미하고
열은 현재 토큰이 참조하려는 key의 위치를 의미합니다</p>

<p>코잘 마스크만 적용하면 세 번째 토큰은 첫 번째부터 세 번째 토큰까지만 볼 수 있고
자신보다 뒤에 있는 네 번째와 다섯 번째 토큰은 미래 위치이므로 볼 수 없습니다</p>

<p>여기에 [1, 1, 1, 0, 0] 형태의 패딩 마스크를 함께 적용하면 모든 토큰은 네 번째와 다섯 번째 위치를 참조할 수 없습니다 첫 번째 문장에서 이 두 위치는 실제 토큰이 아니라 패딩 토큰이기 때문입니다</p>

<p>그러나 현재 코잘 마스크의 크기는 <code class="language-plaintext highlighter-rouge">(5,5)</code>이고 배치에는 문장이 2개 있어서
따라서 각 문장에 동일한 코잘 마스크를 적용할 수 있도록
배치 차원을 추가해줘야 합니다</p>

<p>그냥 개념적으로는 동일한 <code class="language-plaintext highlighter-rouge">(5,5)</code> 코잘 마스크가 각 문장에 하나씩 적용됩니다</p>

<p>이어서 다음으로 패딩 마스크에도 차원을 확장하는데 기존 마스크는 <code class="language-plaintext highlighter-rouge">(2,5)</code>입니다</p>

<pre><code class="text">
[ 
[1, 1, 1, 0, 0], 
[1, 1, 1, 1, 0] 
]
</code></pre>

<p>하지만 새로운 차원을 추가하면 <code class="language-plaintext highlighter-rouge">(2,1,5)</code>가 됩니다 
첫 번째 문장을 기준으로 하면 <code class="language-plaintext highlighter-rouge">[[1, 1, 1, 0, 0]]</code>가 됩니다</p>

<p>가운데 크기를 1로 만드는 이유는 코잘 마스크와 결합할 때
브로드캐스팅을 적용하기 위해서 입니다</p>

<pre><code class="text">
코잘 마스크: (2, 5, 5) 
패딩 마스크: (2, 1, 5)
</code></pre>

<p>패딩 마스크의 가운데 차원인 1이 시퀀스 길이인 5로 확장되면서
동일한 패딩 정보가 모든 행에 적용됩니다</p>

<p>첫 번째 문장의 패딩 마스크가 다음과 같다면,</p>

<pre><code class="text">
[1, 1, 1, 0, 0]
</code></pre>

<p>브로드캐스팅된 형태는 개념적으로 다음과 같습니다</p>

<pre><code class="text">
[
 [1, 1, 1, 0, 0],
 [1, 1, 1, 0, 0],
 [1, 1, 1, 0, 0],
 [1, 1, 1, 0, 0],
 [1, 1, 1, 0, 0]
]
</code></pre>

<p>모든 토큰이 네 번째와 다섯 번째 위치의 패딩 토큰을 참조하지 못하도록
동일한 마스크가 각 행에 적용되는 것입니다
그리고 <code class="language-plaintext highlighter-rouge">minimum()</code> 연산을 통해서 코잘 마스크와 패딩 마스크를 결합합니다
같은 위치에 있는 값 중 작은 값을 선택하면 됩니다</p>

<p>그렇게 최종 어텐션 마스크를 생성하게 됩니다 
이러한 최종 마스크는 현재 토큰보다 뒤에 있는 미래 토큰은 참조할 수 없고
실제 문장이 포함되지 않은 패딩 토큰도 참조할 수 없습니다</p>

<p>최종 어텐션 마스크의 크기는 <code class="language-plaintext highlighter-rouge">(2,5,5)</code>이며 
각 차원의 의미는 <code class="language-plaintext highlighter-rouge">(batch_size, query_length, key_length)</code> 입니다</p>

<p>결국 이 함수는 코잘 마스크와 패딩 마스크를 결합하여 각 토큰이 자신보다 
뒤에 있는 미래 토큰과 실제 내용이 없는 패딩 토큰을 참조하지 못하도록 합니다</p>

<p>이렇게 생성한 최종 어텐션 마스크는 디코더의 마스크드 셀프 어텐션에 전달됩니다</p>

<p><br /></p>

<h2 id="section-3">5. 트랜스포머 디코더 모듈 만들기</h2>

<p>앞에서 코잘 마스크와 패딩 마스크를 결합하여 최종 어텐션 마스크를 만들었습니다 
이제 이 마스크를 사용해 미래 토큰과 패딩 토큰을 참조하지 않는 
트랜스포머 디코더 모듈을 구현해보겠습니다</p>

<p>이번에 구현할 디코더는 GPT와 같은 <strong>디코더 전용 모델</strong>에 사용되는 구조입니다
따라서 인코더의 출력을 참고하는 크로스 어텐션은 사용하지 않고 아래와 같은 요소로 구성됩니다</p>

<ol>
  <li>층 정규화</li>
  <li>마스크드 멀티 헤드 셀프 어텐션</li>
  <li>드롭아웃</li>
  <li>잔차 연결</li>
  <li>피드 포워드 네트워크</li>
</ol>

<p>입력은 <strong>층 정규화 → 마스크드 멀티 헤드 셀프 어텐션 → 드롭아웃 → 잔차 연결 →
층 정규화 → 피드 포워드 네트워크 → 드롭아웃 → 잔차 연결 → 출력</strong> 순서로 처리됩니다.</p>

<p>먼저 어텐션 마스크를 케라스 층으로 만들면 <code class="language-plaintext highlighter-rouge">make_attention_mask()</code> 함수는
패딩 마스크와 코잘 마스크를 결합하여 최종 어텐션 마스크를 반환합니다</p>

<p>이를 케라스 모델 내부에서 사용하기 위해서 
간단한 사용자 정의 층으로 만들어보겠습니다</p>

<pre><code class="python">
class AttentionMask(keras.layers.Layer):
  def call(self, padding_mask):
    return make_attention_mask(padding_mask)
</code></pre>

<p><code class="language-plaintext highlighter-rouge">AttentionMask</code> 클래스는 <code class="language-plaintext highlighter-rouge">keras.layers.Layer</code>를 상속받습니다.
그리고 <code class="language-plaintext highlighter-rouge">call()</code> 메서드에서 앞서 만든 <code class="language-plaintext highlighter-rouge">make_attention_mask()</code> 함수를 호출합니다
따라서 크기가 <code class="language-plaintext highlighter-rouge">(batch_size, seq_len)</code>인 패딩 마스크를 입력하면
코잘 마스크와 결합된 <code class="language-plaintext highlighter-rouge">(batch_size, seq_len, seq_len)</code> 
크기의 최종 어텐션 마스크를 반환합니다.</p>

<pre><code class="text">
attention_mask = AttentionMask()(padding_mask)
</code></pre>

<p>이렇게 만든 어텐션 마스크는 뒤에서 <code class="language-plaintext highlighter-rouge">MultiHeadAttention</code> 층의 
<code class="language-plaintext highlighter-rouge">attention_mask</code> 매개변수로 전달됩니다</p>

<p>이제 트랜스포머 디코더 모듈을 구현해보겠습니다</p>

<pre><code class="python">
def transformer_decoder(
    x,
    padding_mask,
    dropout,
    activation="relu",
    norm_first=True,
):
    # 패딩 마스크와 코잘 마스크를 결합
    attention_mask = AttentionMask()(padding_mask)

    # 첫 번째 잔차 연결을 위해 입력을 저장
    residual = x

    # 각 어텐션 헤드가 사용할 차원을 계산
    key_dim = hidden_dim // num_heads

    # Pre-Norm을 사용하는 경우 어텐션 전에 정규화
    if norm_first:
        x = layers.LayerNormalization()(x)

    # 마스크드 멀티 헤드 셀프 어텐션
    x = layers.MultiHeadAttention(
        num_heads=num_heads,
        key_dim=key_dim,
        dropout=dropout,
    )(
        query=x,
        value=x,
        attention_mask=attention_mask,
    )

    x = layers.Dropout(dropout)(x)

    # 첫 번째 잔차 연결
    x = x + residual

    # Post-Norm을 사용하는 경우 잔차 연결 후 정규화
    if not norm_first:
        x = layers.LayerNormalization()(x)

    # 두 번째 잔차 연결을 위해 현재 값을 저장
    residual = x

    # Pre-Norm을 사용하는 경우 피드 포워드 네트워크 전에 정규화
    if norm_first:
        x = layers.LayerNormalization()(x)

    # 위치별 피드 포워드 네트워크
    x = layers.Dense(
        hidden_dim * 4,
        activation=activation,
    )(x)

    x = layers.Dense(hidden_dim)(x)
    x = layers.Dropout(dropout)(x)

    # 두 번째 잔차 연결
    x = x + residual

    # Post-Norm을 사용하는 경우 잔차 연결 후 정규화
    if not norm_first:
        x = layers.LayerNormalization()(x)

    return x
</code></pre>
<p>코드를 설명을 조금 하면 먼저 입력으로 전달된 패딩 마스크를 이용하여
최종 어텐션 마스크를 만들게 됩니다 이 마스크는 두 가지 조건이 포함되어 있는데</p>

<ul>
  <li>현재 위치보다 뒤에 있는 미래 토큰을 가리는 코잘 마스크</li>
  <li>실제 내용이 없는 패딩 토큰을 가리는 패딩 마스크</li>
</ul>

<p>따라서 디코더는 미래의 정답과 패딩 토큰을 참고하지 않고
현재까지 등장한 실제 토큰만을 이용해 어텐션을 계산하게 됩니다</p>

<p>그래서 어텐션 연산을 수행하기 전에 현재 입력 <code class="language-plaintext highlighter-rouge">x</code>를 <code class="language-plaintext highlighter-rouge">residual</code>에 저장하고
이 값은 어텐션 연산이 끝난 뒤 다음과 같이 다시 더해집니다</p>

<p><code class="language-plaintext highlighter-rouge">x = x + residual</code></p>

<p>이러한 구조를 <strong>잔차 연결, Residual Connection</strong>이라고 합니다
잔차 연결은 층을 통과하기 전의 정보를 이후 출력에 직접 더해주는 방법입니다
이를 통해 모델이 깊어져도 기존 정보와 기울기가 비교적 안정적으로 전달될 수 있습니다</p>

<p>잔차 연결에서는 두 텐서를 서로 더해야 하므로 입력과 출력의 마지막의 차원이 같아야 합니다
따라서 디코더의 입력과 출력은 모두 <code class="language-plaintext highlighter-rouge">hidden_dim</code> 크기를 유지합니다</p>

<p><code class="language-plaintext highlighter-rouge">hidden_dim</code>은 하나의 토큰을 표현하는 전체 임베딩 차원이고
<code class="language-plaintext highlighter-rouge">num_heads</code>는 어텐션 헤드의 개수입니다</p>

<p>예를 들어 각각 768, 12 라고 가정을 하면 각 어텐션 헤드가 처리하는 차원은 
64차원으로 12개의 어텐션 헤드가 각각 64차원의 정보를 처리하게 됩니다</p>

<p>각 헤드는 서로 다른 관점에서 토큰 사이의 관계를 학습하고 
마지막에는 각 헤드의 결과가 다시 결합됩니다</p>

<p>또 <code class="language-plaintext highlighter-rouge">norm_first</code>는 층 정규화를 어느 위치에 적용할지 결정하는 매개변수로
<code class="language-plaintext highlighter-rouge">norm_first=True</code>라면 어텐션이나 피드 포워드 네트워크를 
통과하기 전에 층 정규화를 적용합니다</p>

<p>층 정규화 -&gt; 어텐션 -&gt; 잔차 연결 이러한 구조를 <strong>Pre-Norm</strong>이라고 합니다
반대로 False라면 잔차 연결을 수행한 뒤 층 정규화를 적용합니다 
이러한 구조는 <strong>Post-Norm</strong>이라고 합니다</p>

<p>해당 코드에서는 하나의 함수를 이용해 두 가지 구조를 모두 선택할 수 있도록 만들었습니다</p>

<pre><code class="python">
    # 마스크드 멀티 헤드 셀프 어텐션
    x = layers.MultiHeadAttention(
        num_heads=num_heads,
        key_dim=key_dim,
        dropout=dropout,
    )(
        query=x,
        value=x,
        attention_mask=attention_mask,
    )
</code></pre>

<p>여기에서는 멀티 헤드 셀프 어텐션을 수행합니다
 <code class="language-plaintext highlighter-rouge">query</code>와 <code class="language-plaintext highlighter-rouge">value</code>에 동일한 <code class="language-plaintext highlighter-rouge">x</code>를 전달했기 때문에 입력 문장 내부의 토큰들이
 서로의 관계를 계산하는 셀프 어텐션이 됩니다</p>

<p>이때 <code class="language-plaintext highlighter-rouge">key</code>를 별도로 전달하지 않으면 <code class="language-plaintext highlighter-rouge">value</code>가 <code class="language-plaintext highlighter-rouge">key</code>로도 사용됩니다
따라서 개념적으로 모두 <code class="language-plaintext highlighter-rouge">x</code> 가 됩니다 그리고 <code class="language-plaintext highlighter-rouge">attention_mask</code>에서 
앞서 만든 최종 어텐션 마스크를 전달합니다</p>

<p>일반적인 셀프 어텐션은 문장의 모든 토큰을 참조할 수 있지만 여기서는
코잘 마스크가 적용되어 자신보다 뒤에 있는 미래 토큰을 참조할 수 없습니다</p>

<p>또한 패딩 마스크도 함께 적용되므로 실제 내용이 없는 패딩 토큰도 참조하지 않습니다</p>

<p>따라서 해당 층이 디코더의 <strong>마스크드 멀티 헤드 셀프 어텐션</strong> 역할을 합니다</p>

<p>어텐션 결과에는 드롭아웃을 적용합니다
드롭아웃은 학습 중 일부 값을 무작위로 제외하여 모델이 특정 정보에 지나치게
의존하는 것을 줄여줍니다 그 다음 어텐션을 통과하기 전의 입력인 <code class="language-plaintext highlighter-rouge">residual</code>를 더합니다</p>

<p>그렇게 하면 어텐션을 통해 새롭게 계산한 정보와 
기본 입력 정보를 함께 다음 단계로 전하게 됩니다</p>

<p>어텐션 연산이 끝나면 각 토큰은 다른 토큰과의 관계를 반영한 정보를 가지게 됩니다
이제 각 토큰의 표현을 개별적으로 변환하기 위해 피드 포워드 네트워크를 통과시킵니다</p>

<p>피드 포워드 네트워크는 코드에서 두 개의 밀집층으로 구성되는데 
차원을 확장했다가 다시 원래 크기로 줄입니다
중간 차원을 크게 확장하면 모델이 각 토큰의 특징을 더 풍부하게 변환할 수 있습니다</p>

<p>그리고 마지막 차원을 다시 <code class="language-plaintext highlighter-rouge">hidden_dim</code>으로 줄여야 
기존 입력과 잔차 연결을 수행할 수 있습니다</p>

<p>활성화 함수는 기본적으로 <code class="language-plaintext highlighter-rouge">relu</code>를 사용하게 설정했지만 
GPT 계열에서는 <code class="language-plaintext highlighter-rouge">gelu</code>를 자주 사용합니다</p>

<p>그 다음에는 두 번째 잔차 연결을 하게 됩니다
피드 포워드 네트워크 출력에도 드롭아웃을 적용하고 네트워크를 통과하기 전에
입력을 더합니다 그래서 하나의 디코더 블록에는 총 두 번의 잔차연결이 됩니다
마지막으로 필요한 위치에 층 정규화를 적용한 뒤 결과를 반환합니다</p>

<p>이렇게 완성된 <code class="language-plaintext highlighter-rouge">transformer_decoder()</code> 함수는 입력과 동일한 형태의 출력을
반환합니다 입력의 크기가 같다면 디코더를 통과한 출력의 크기도 동일합니다
그래서 디코더 블록을 여러 개 연속으로 쌓을 수 있습니다</p>

<p>정리를 하면 이번에 만든 트랜스포머 디코더 모듈은 마스크드 멀티 헤드 셀프 어텐션을 
통해 이전 토큰들의 관계를 분석하고 피드 포워드 네트워크를 통해
각 토큰의 표현을 변환합니다 그리고 층 정규화와 잔차 연결을 사용하여
디코더 블록을 안정적으로 쌓을 수 있도록 구성합니다</p>

<p>이제 완성한 디코더 모듈을 여러 층으로 쌓고 토큰 임베딩과 위치 임베딩을 연결하여
실제 GPT-2 구조의 언어 모델을 만들어보겠습니다</p>

<p><br /></p>

<h2 id="gpt-2--">6. GPT-2 모델 만들기</h2>

<p>앞에서 트랜스포머 디코더 모듈을 완성했습니다</p>

<p>이제 토큰 임베딩과 위치 임베딩을 연결하고 디코더 블록을 
여러 층으로 쌓아 GPT-2 구조의 언어 모델을 만들어보겠습니다</p>

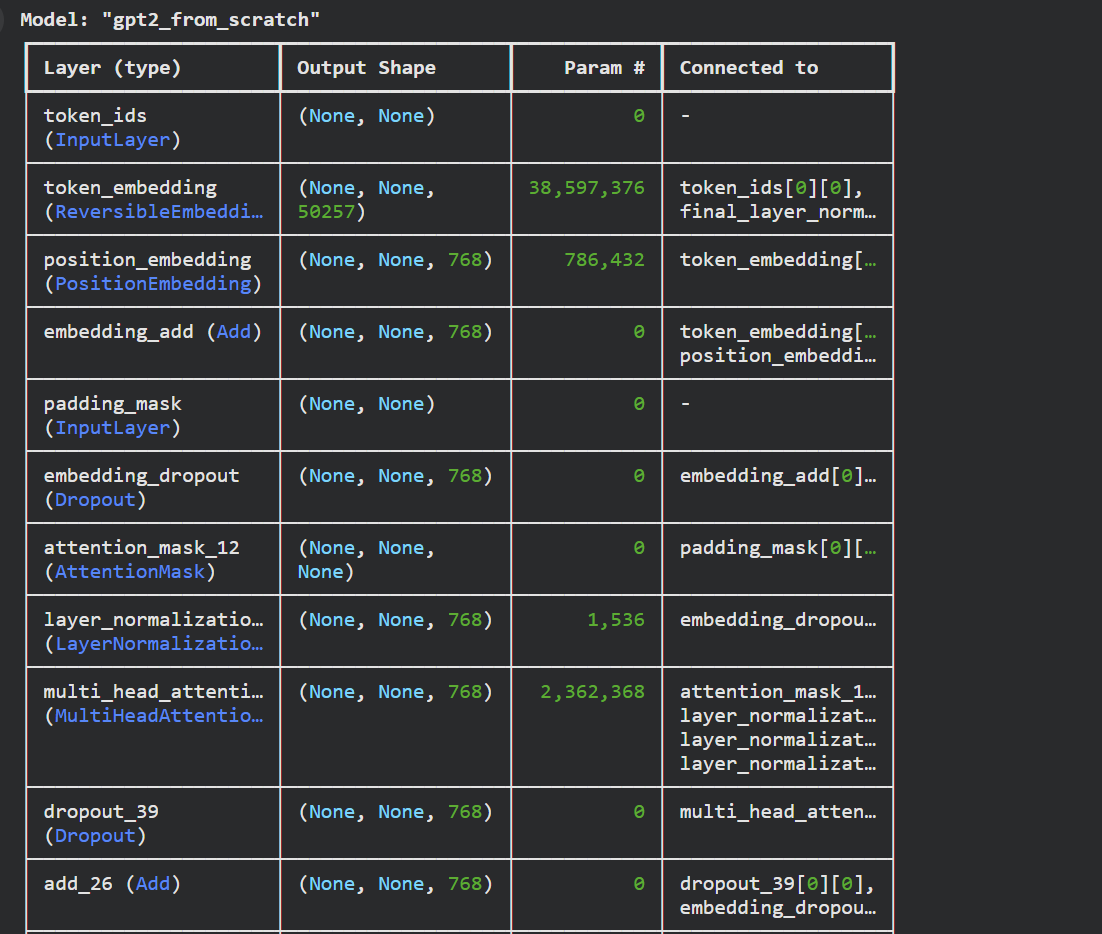
<p>이번에 구현할 모델은 GPT-2 Base와 유사한 하이퍼파라미터를 사용합니다.
먼저 모델을 만드는 데 필요한 하이퍼파라미터를 설정해야 합니다</p>

<pre><code class="python">
vocab_size = 50257 
num_layers = 12 
num_heads = 12 
hidden_dim = 768 
dropout = 0.1 
activation = "gelu" 
max_seq_len = 1024
</code></pre>

<p>GPT-2 Base는 50257개의 토큰으로 구성된 어휘 사전을 사용하고 768차원의
은닉 표현을 사용합니다 또한 하나의 디코더 블록에는 12개의 어텐션 헤드가 있으며
이러한 디코더 블록을 12개 쌓습니다. 따라서 각 어텐션 헤드는 64차원을 처리합니다.</p>

<pre><code class="python">
token_ids = keras.Input(
    shape=(None,),
    dtype="int32",
    name="token_ids",
)

padding_mask = keras.Input(
    shape=(None,),
    dtype="bool",
    name="padding_mask",
)
</code></pre>
<p>모델은 두 가지 값을 입력으로 받습니다</p>

<p><code class="language-plaintext highlighter-rouge">token_ids</code>는 토큰마다 부여된 정수 형태의 ID인데 
예를 들어 하나의 문장이 다음과 같이 토큰화 되어 있다고 해보겠습니다</p>

<p><code class="language-plaintext highlighter-rouge">[1024, 35, 827, 91]</code></p>

<p>각 숫자는 GPT-2의 어휘사전에 등록된 특정 토큰을 의미합니다</p>

<p><code class="language-plaintext highlighter-rouge">padding_mask</code>는 입력에서 실제 토큰과 패딩 토큰을 구분하는 역할을 합니다
<code class="language-plaintext highlighter-rouge">[1,1,1,1,0,0]</code> 있다면 1은 실제 토큰이고 
0은 문장의 길이를 맞추기 위해 추가한 패딩 토큰입니다</p>

<p>두 입력 모두 문장마다 길이가 달라질 수 있으므로 <code class="language-plaintext highlighter-rouge">shape=(None,)</code>으로 설정됩니다 
여기서 <code class="language-plaintext highlighter-rouge">None</code>은 모델이 실행될 때 시퀀스 길이가 결정된다는 의미입니다</p>

<p>그 다음은 정수 형태의 토큰 ID를 벡터로 변환하기 위한 토큰 임베딩을 만듭니다</p>

<pre><code class="python">
from keras_nlp.layers import ReversibleEmbedding

token_embedding_layer = ReversibleEmbedding(
    input_dim=vocab_size,
    output_dim=hidden_dim,
)

token_embedding = token_embedding_layer(token_ids)
</code></pre>

<p><code class="language-plaintext highlighter-rouge">ReversibleEmbedding</code>은 정수 형태의 토큰 ID를 <code class="language-plaintext highlighter-rouge">hidden_dim</code> 크기의 벡터로 변환합니다
지금 보면 768이므로 각각의 토큰은 768차원의 벡터로 표현됩니다</p>

<p>입력의 크기가 <code class="language-plaintext highlighter-rouge">(batch_size, seq_len)</code> 이라면 토큰 임베딩을 통과한 결과는 
<code class="language-plaintext highlighter-rouge">(batch_size, seq_len, 768)</code> 이 됩니다 하지만 셀프 어텐션은 토큰의 순서를
자체적으로 구분하지 못합니다 그래서 첫 번째 토큰과 두 번째 토큰이 서로 다른 위치에
있다는 정보를 모델에 전달하기 위해 위치 임베딩을 추가해야 합니다</p>

<pre><code class="python">
pos_embedding = keras_nlp.layers.PositionEmbedding(
    sequence_length=max_seq_len,
)(token_embedding)
</code></pre>

<p>위치 임베딩 역시 토큰 임베딩과 동일하게 768차원의 벡터를 생성합니다
이제 토큰의 의미를 나타내는 토큰 임베딩과 토큰의 순서를 나타내는 위치 임베딩을 더합니다</p>

<pre><code class="python">
x = token_embedding + pos_embedding
</code></pre>

<p>두 임베딩을 결합하면 각 토큰은 자신의 의미와 문장 안에서의 위치 정보를 함께 가지게 됩니다
그 다음에는 결합된 임베딩에 드롭아웃을 적용합니다</p>

<pre><code class="python">
x = layers.Dropout(dropout)(x)
</code></pre>

<p>이제 앞에서 만든 <code class="language-plaintext highlighter-rouge">transformer_decoder()</code> 함수를 이용해 디코더 블록을 12개 쌓습니다.</p>

<pre><code class="python">
for _ in range(num_layers):
    x = transformer_decoder(
        x,
        padding_mask,
        dropout,
        activation,
    )
</code></pre>

<p><code class="language-plaintext highlighter-rouge">num_layers</code>가 12이므로 반복문이 실행되면서 입력은 
총 12개의 트랜스포머 디코더 블록을 차례대로 통과합니다</p>

<p>각 디코더 블록에서는 마스크드 멀티 헤드 셀프 어텐션을 통해 이전 토큰들과의
관계를 분석하고 피드 포워드 네트워크를 통해 각 토큰의 표현을 변환합니다</p>

<p>디코더 블록의 입력과 출력은 모두 <code class="language-plaintext highlighter-rouge">(batch_size, seq_len, hidden_dim)</code> 을 유지하며
따라서 같은 디코더 블록을 여러 번 연속으로 연결할 수 있습니다</p>

<p>모든 디코더 블록을 통과한 결과에는 마지막 층 정규화를 적용합니다</p>

<pre><code class="python">
x = layers.LayerNormalization()(x)
</code></pre>

<p>현재 <code class="language-plaintext highlighter-rouge">x</code>의 마지막 차원은 768 이지만 언어 모델이 다음 토큰을 예측하려면
768차원의 출력을 어휘사전 크기인 50257차원으로 변환해야 합니다</p>

<p>일반적으로는 밀집층을 사용할 수 있지만 우리는 앞에서 
만든 <code class="language-plaintext highlighter-rouge">ReversibleEmbedding</code>을 반대 방향으로 다시 사용합니다</p>

<pre><code class="python">
outputs = token_embedding_layer(
    x,
    reverse=True,
)
</code></pre>

<p>입력 단계에서는 토큰 ID를 768차원의 임베딩으로 썼지만
마지막 출력 단계에서는 <code class="language-plaintext highlighter-rouge">reverse=True</code>를 사용하여 반대 방향으로 변환합니다</p>

<p>이처럼 입력 임베딩의 가중치를 출력층에서도 다시 사용하는 방식을 
<strong>가중치 공유</strong> 또는 <strong>Weight Tying</strong>이라고 합니다</p>

<p>입력 임베딩과 출력층이 같은 가중치를 공유하기 때문에 별도의 출력층 가중치를 
추가하지 않고도 각 위치에서 다음 토큰에 대한 점수를 계산할 수 있습니다</p>

<p>현재 vocab_size가 50,257이므로 각 토큰 위치마다 50,257개의 로짓이 출력됩니다 
각 위치의 로짓값은 서로 다르며, 어휘사전에 포함된 각 토큰이 
다음 토큰으로 등장할 가능성을 나타냅니다</p>

<pre><code class="python">
model = keras.Model(
    inputs={
        "token_ids": token_ids,
        "padding_mask": padding_mask,
    },
    outputs=outputs,
)

model.summary()
</code></pre>

<p>이제 입력과 출력을 연결하여 전체 GPT-2 모델을 완성합니다</p>

<p><img src="https://velog.velcdn.com/images/newkid0714/post/3a081716-ebb0-43af-805f-89d4f0b8c967/image.png" alt="GPT-2 유사 모델의 Keras 모델 요약" width="800" /></p>

<p>이렇게 토큰 임베딩과 위치 임베딩을 결합하고 트랜스포머 디코더 블록을
12개 쌓아 GPT-2 Base와 유사한 구조의 언어 모델을 만들어봤습니다.</p>

<p>모델에 토큰 ID와 패딩 마스크를 입력하면 각 토큰 위치에서 
다음에 등장할 수 있는 모든 토큰의 점수가 출력됩니다</p>

<p>학습할 때는 이 출력과 한 칸씩 이동한 정답 토큰을 비교하고
실제 다음 토큰에 해당하는 확률이 높아지도록 모델의 가중치를 조정합니다</p>

<p><br /></p>

<h2 id="section-4">마무리</h2>

<p>이번 시간에는 트랜스포머 디코더가 다음 토큰을 예측하는 원리부터
코잘 마스크와 패딩 마스크를 결합하는 방법 그리고 디코더 블록을 여러 층으로 쌓아
GPT-2 구조의 언어 모델을 만드는 과정까지 알아봤습니다</p>

<p>다음 시간에는 인코더가 입력 문장의 핵심 의미를 이해하고
디코더가 이를 바탕으로 새로운 문장을 생성하는 트랜스포머 인코더-디코더 모델을 만들어
실제 텍스트를 요약해보도록 하겠습니다</p>

<p>지금까지 에코노베이션 29기 안성준이였습니다</p>]]></content><author><name>안성준</name></author><category term="Tech" /><category term="Tech" /><summary type="html"><![CDATA[지난 시간에는 트랜스포머 인코더를 활용해 텍스트를 분류하는 방법을 알아봤습니다. 이번 시간에는 텍스트 생성에 뛰어난 트랜스포머 디코더의 원리를 살펴보고, GPT-2 Base와 유사한 구조의 언어 모델을 직접 구현해보겠습니다.]]></summary></entry><entry><title type="html">에코노 뉴스 6월호</title><link href="https://jnu-econovation.github.io/econo_news/2026/06/29/%EC%97%90%EC%BD%94%EB%85%B8-%EB%89%B4%EC%8A%A4-6%EC%9B%94%ED%98%B8.html" rel="alternate" type="text/html" title="에코노 뉴스 6월호" /><published>2026-06-29T00:00:00+09:00</published><updated>2026-06-29T00:00:00+09:00</updated><id>https://jnu-econovation.github.io/econo_news/2026/06/29/%EC%97%90%EC%BD%94%EB%85%B8%20%EB%89%B4%EC%8A%A4%206%EC%9B%94%ED%98%B8</id><content type="html" xml:base="https://jnu-econovation.github.io/econo_news/2026/06/29/%EC%97%90%EC%BD%94%EB%85%B8-%EB%89%B4%EC%8A%A4-6%EC%9B%94%ED%98%B8.html"><![CDATA[<h2 id="section">에코노 뉴스 6월호</h2>

<p><img src="https://velog.velcdn.com/images/turtlestory/post/c779b7e4-5525-44fe-b488-e18ebf0ed200/image.png" alt="표지" /></p>

<p>에코노베이션의 다양한 활동을 기록하고 알리기 위해 에코노 뉴스 6월호가 찾아왔습니다.🍃</p>

<p>6월의 에코노베이션은 시험 기간을 맞아 Let’s Power Up 행사부터 네트워킹 행사까지 있었는데요.</p>

<p>6월의 에코노베이션에서는 어떤 이야기들이 있었는지 함께 살펴볼까요?</p>

<hr />

<p><br /></p>

<h3 id="lets-power-up-">Let’s Power Up 🍫</h3>

<p>기말고사 기간을 맞아 열심히 공부하고 있는 에코노베이션 회원들을 위해 Let’s Power Up 행사가 진행되었습니다!</p>

<p><img src="https://velog.velcdn.com/images/turtlestory/post/e4eb5129-7996-4e5a-852b-b42d13bc3636/image.png" alt="Let's Power Up_1" /></p>

<p>이번 행사에서는 비타500, 쌀과자, 초코파이 등 다양한 간식들이 준비되어 있었는데요! 특히 간식이 담긴 종이 가방에는 회원들을 응원하는 한마디가 적혀 있어, 힘을 얻을 수 있었습니다. ✨</p>

<p>맛있는 간식과 응원 문구 덕분에 잠시나마 에너지를 충전할 수 있었던 시간이었습니다!</p>

<p>이번 행사를 준비해 주신 회장단 분들께 감사드리며, 특히 힘이 되는 문구를 정성껏 작성해 주신 현솔님께도 감사드립니다! 🙇‍♀️</p>

<p><img src="https://velog.velcdn.com/images/turtlestory/post/7dfbd7a1-5b51-47da-9adf-f53554609db8/image.png" alt="Let's Power Up_2" /></p>

<hr />

<p><br /></p>

<h3 id="section-1">네트워킹 행사 💬</h3>

<p>26-1학기 네트워킹 행사가 진행되었습니다! 이번 네트워킹 행사는 에코노베이션 회원들이 서로의 생각을 나누며 더 가까워질 수 있는 시간이었는데요.</p>

<p><img src="https://velog.velcdn.com/images/turtlestory/post/6a265369-6ac3-4663-9b8f-365298385d9e/image.png" alt="네트워킹1" /></p>

<p>첫 번째 세션에서는 빙고 게임을 진행했는데요!
에코노베이션 키워드로 빙고를 하며 즐겁게 분위기를 풀어갈 수 있는 시간이었습니다. 🎲</p>

<p>두 번째 세션에서는 상현님께서 준비해 주신 앱을 활용해 질문을 뽑고 답변하는 시간을 가졌습니다.</p>

<p>해보고 싶은 프로젝트, 에코노베이션에 들어와서 달라진 점, 나만의 맛집 등 다양한 질문에 대해 답하며 서로를 더 알아갈 수 있었습니다.</p>

<p><img src="https://velog.velcdn.com/images/turtlestory/post/ddb653f1-561d-4ae9-9f12-418e2569a616/image.png" alt="네트워킹2" /></p>

<p>네트워킹 행사가 끝난 후에는 함께 삼겹살을 먹으러 갔습니다. 🥓
맛있는 음식을 먹으며 더 많은 이야기를 나누고, 회원들끼리 한층 더 친해질 수 았는 시간이었습니다!</p>

<hr />

<p><br /></p>

<p>에코노 뉴스 6월호는 여기까지입니다.</p>

<p>시험 기간을 응원하는 Let’s Power Up 행사와 서로의 이야기를 나누며 더 가까워진 네트워킹 행사까지,즐거운 순간들로 가득했던 6월이었습니다.🤝</p>

<p>다가오는 7월호에서도 더 재미있는 소식으로 찾아오겠습니다!</p>]]></content><author><name>joonhyun</name></author><category term="ECONO_NEWS" /><category term="ECONO_NEWS" /><summary type="html"><![CDATA[에코노 뉴스 6월호]]></summary></entry></feed>